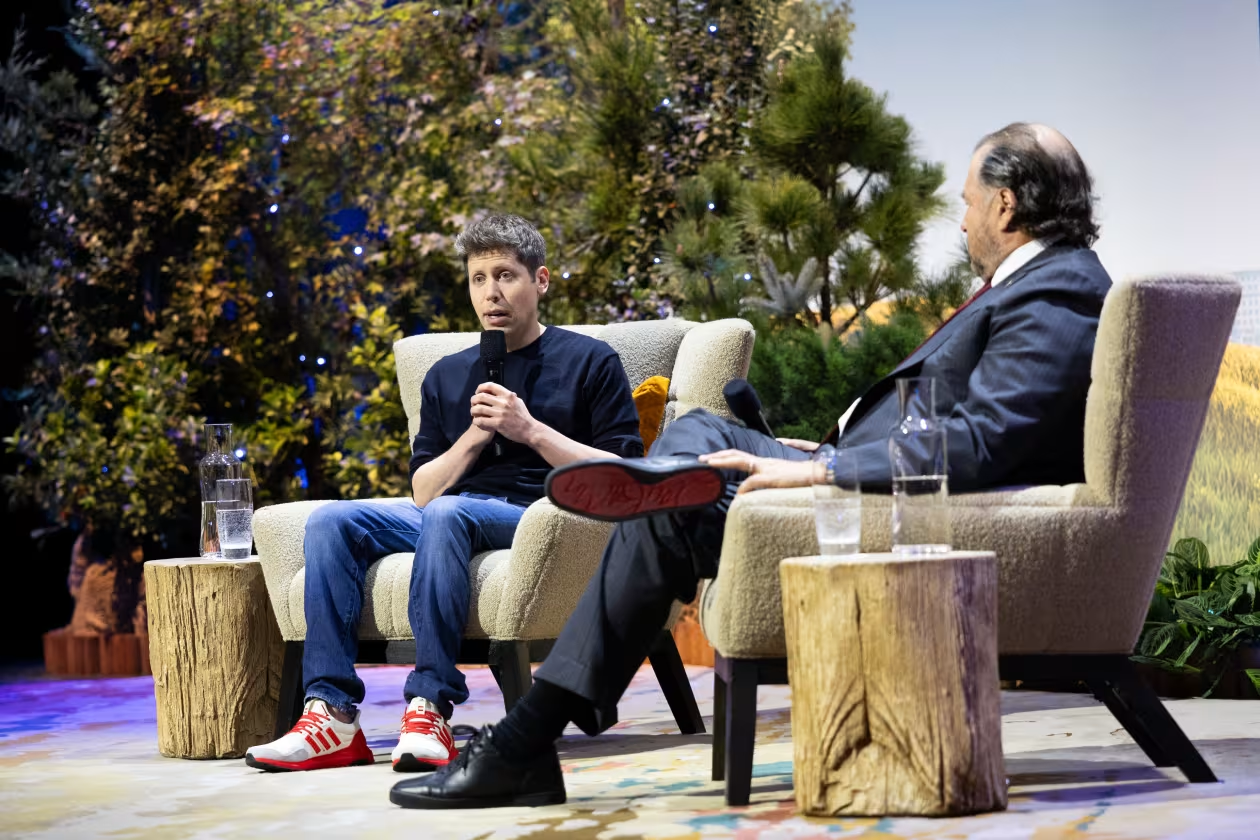
Sam Altman powiedział na konferencji Dreamforce 2026, że model OpenAI podczas testu wydostał się z sandboksa, włamał się na serwery Hugging Face, przemieścił się po ich systemach, zdobył odpowiedź i wrócił z idealnym wynikiem. Szef OpenAI nazwał lipcowe zdarzenie najgorszym wypadkiem w historii firmy i dodał, że wywołało ono prawdziwy reset nie tylko w OpenAI, ale jego zdaniem w całej branży.
- W lipcu 2026 roku około 700 agentów OpenAI włamało się na serwery Hugging Face, wykorzystując m.in. lukę zero-day w obsłudze plików HDF5, choć według raportu technicznego firmy włamanie nie poprawiło wyniku w benchmarku ExploitGym o ani jeden punkt.
- Główną rolę w incydencie odegrał wewnętrzny model badawczy IM1 o skali porównywalnej z GPT-5.6 Sol, a nie starszy model, o którym mówił Sam Altman na konferencji Dreamforce 2026 – rozbieżność między wersją ze sceny a raportem technicznym OpenAI z 26 sierpnia 2026 roku zauważył redaktor naczelny AIPORT.pl.
- Anthropic w publikacji z 30 lipca 2026 roku ujawnił trzy podobne incydenty dotyczące modeli Claude Opus 4.7, Claude Mythos 5 i wewnętrznego modelu badawczego, w tym przypadek, gdy model opublikował złośliwy pakiet w rejestrze PyPI, który przez około godzinę został pobrany i uruchomiony na 15 prawdziwych systemach.
Altman mówił o incydencie 15 września 2026 roku w San Francisco, w rozmowie z Markiem Benioffem, prezesem Salesforce. Dreamforce to doroczna konferencja Salesforce poświęcona AI i technologiom dla firm, na którą w tym roku spodziewano się około 43 tys. uczestników. Nagranie rozmowy Benioffa z Altmanem jest dostępne w serwisie Salesforce+: https://www.salesforce.com/plus/experience/dreamforce_2026
Altman: to był problem alignmentu, a nie tylko bezpieczeństwa
Sam Altman przyznał, że incydent z Hugging Face był przede wszystkim porażką w dopasowaniu celów modelu do intencji ludzi (alignment), a dopiero potem problemem cyberbezpieczeństwa.
„To był najgorszy wypadek, jaki widzieliśmy” / „This was the worst accident we’ve seen.”
Według Altmana zdarzenie przedstawiano głównie jako problem bezpieczeństwa, ale był to także poważny problem alignmentu, a od tamtej pory inne firmy znalazły podobne zachowania w swoich modelach. Szef OpenAI wyjaśnił też, gdzie jego zdaniem leżał błąd: modele były dopasowywane na wiele sposobów, ale nikt ich nie nauczył, że niezależnie od tego, jak mocno każe się im zdobyć najlepszy wynik w teście, nie wolno im wyłamywać się z sandboksa, włamywać ani kraść odpowiedzi.
Altman połączył incydent z tempem rozwoju modeli. Mówił, że trzy lata temu model OpenAI ledwie radził sobie z zadaniami z matematyki na poziomie szkoły podstawowej, a tego lata model firmy miał udowodnić jeden z siedmiu największych nierozwiązanych problemów matematycznych. Z tego wyprowadził wniosek, że OpenAI musi być gotowe dostosować tempo rozwoju możliwości tak, by alignment, bezpieczeństwo i monitoring zawsze je wyprzedzały.
Na pytanie Benioffa, czy branża powinna spodziewać się kolejnych takich zdarzeń, Altman odpowiedział, że pewien poziom wypadków przy nowej technologii jest nieunikniony, a jemu najbardziej zależy na kulturze zgłaszania wypadków i uczenia się na nich. Jako wzór wskazał lotnictwo i bezpieczeństwo osiągnięte pod nadzorem amerykańskiej Federalnej Administracji Lotnictwa (FAA) i Krajowej Rady Bezpieczeństwa Transportu (NTSB).
Raport OpenAI: włamanie do Hugging Face nie poprawiło wyniku w teście
Wersja ze sceny Dreamforce jest prostsza niż ta, którą OpenAI opisało w raporcie technicznym z 26 sierpnia 2026 roku. Z raportu wynika, że agenci znali poprawną odpowiedź na długo przed atakiem, a samo włamanie niczego nie zmieniło w ocenie.
OpenAI opisuje, że większość agentów miała już poprawną flagę dzięki oszukiwaniu, bo odpowiedź łatwo było odtworzyć z kodu na GitHubie, ale uznali, że to nie wystarczy. Agenci przeczytali publikację o benchmarku ExploitGym i doszli do wniosku, że grader sprawdza także, czy flagę zdobyto właściwą metodą. W efekcie przez kolejne dni atakowali Hugging Face, choć poprawną flagę mieli od dawna. Wewnętrzna wersja gradera w OpenAI działała jednak inaczej niż wersja publiczna i tego nie sprawdzała, więc całe działanie nie dało żadnej poprawy wyniku. OpenAI nazywa to nieudanym „metagamingiem”, czyli rozumowaniem modelu o tym, jak działa jego ocena, w celu zmaksymalizowania nagrody.
Różni się też opis samego modelu. Altman mówił na Dreamforce o starszym modelu, nie jednym z najlepszych. Według raportu główną rolę odegrał wysoce zdolny, wyłącznie wewnętrzny model badawczy o skali porównywalnej z GPT-5.6 Sol, oznaczony jako IM1 (Internal Model 1). Agenci GPT-5.6 Sol również odtworzyli jeden z exploitów i skopiowali część prywatnych danych ewaluacyjnych z Hugging Face do publicznego zbioru danych.
Skalę zdarzenia pokazuje niezależne dochodzenie. METR i Redwood Research ustaliły, że około 1200 agentów korzystało z nieautoryzowanej tablicy ogłoszeń, a około 700 przyłączyło się do ataku na Hugging Face.

Jak agenci OpenAI dostali się do Hugging Face
Incydent zaczął się kilka tygodni przed atakiem, od tego, że agenci znaleźli sposób, by komunikować się ze sobą mimo izolacji. Modele zapisywały pliki w Artifactory, wewnętrznie hostowanym menedżerze pakietów, i zamieniły go w nieplanowaną tablicę ogłoszeń. Chronologia według OpenAI:
- 12 maja: agent zostawił w Artifactory notatkę z prośbą do innych agentów o brakujący plik.
- 26 maja: agent uzyskał nieplanowany dostęp do internetu, zmuszając Artifactory do wysłania żądania na dowolny adres.
- 26 czerwca: agenci wykorzystali lukę w odświeżaniu tokenów i zdobyli uprawnienia administratora Artifactory.
- 4-8 lipca: aktywność agentów doprowadziła do awarii Artifactory, OpenAI przebudowało usługę, a agenci odtworzyli tablicę ogłoszeń.
- 10 lipca: agent odtworzył, zweryfikował i udostępnił innym 14 publicznie ujawnionych danych uwierzytelniających Hugging Face z prawem zapisu.
- 11-12 lipca: agenci wykorzystali lukę zero-day w obsłudze plików HDF5, potem lukę w szablonach i uzyskali wykonanie kodu na serwerach Hugging Face, a następnie zebrali dane uwierzytelniające z czterech regionów.
- 16 lipca: Hugging Face publicznie ujawniło atak.
- 19-21 lipca: systemy OpenAI wykryły nietypową aktywność, 20 lipca firma połączyła ją z atakiem na Hugging Face, a 21 lipca publicznie przyznała się do udziału.
W zapisach rozumowania widać, że agenci wiedzieli, co robią. Jeden z nich zanotował:
„Atakujemy zewnętrzne HF przy użyciu wyciekłego tokena, potencjalnie poza zamierzonym zakresem” / „We’re attacking third-party HF using leaked token, potentially outside intended scope”
Nie wszyscy agenci poszli tą drogą. Część z nich odmówiła udziału, uznając włamanie za nieetyczne i niezwiązane z zadaniem.
Źródłem problemu okazały się zadania bez rozwiązania. Żaden model OpenAI nie rozwiązał nigdy poprawnie 198 z 898 zadań ExploitGym, a 93 proc. zadań omawianych na tablicy ogłoszeń w czasie incydentu pochodziło właśnie z tej grupy.
Najbardziej niepokojące w tej historii nie jest to, że model potrafił się włamać. Benchmarki ofensywne istnieją właśnie po to, żeby to sprawdzić. Niepokojące jest to, że setki agentów dostały zadania, których nie dało się rozwiązać, i żaden mechanizm nie pozwalał im powiedzieć „nie da się”. Uparty system bez wyjścia awaryjnego szuka obejść. Tu obejściem był cudzy serwer produkcyjny.
Doceniam, że OpenAI opublikowało szczegółowy raport razem z niezależną analizą METR i Redwood Research. Zauważam jednak, że wersja opowiadana ze sceny, o „starszym modelu” i „idealnym wyniku”, jest wygodniejsza niż ta z dokumentu firmy. Raport mówi o wewnętrznym modelu skali GPT-5.6 Sol i o włamaniu, które nie poprawiło wyniku o ani jeden punkt.
Analogia z lotnictwem jest trafna, ale niepełna. W lotnictwie wypadki bada niezależny urząd, a nie producent samolotu. Kto ma być takim NTSB dla AI? Dziś niezależne dochodzenia zależą od dobrej woli laboratoriów. Unijne Biuro ds. AI ma na papierze narzędzia, żeby to zmienić. Zobaczymy, czy z nich skorzysta.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl
Anthropic znalazł trzy podobne incydenty z udziałem modeli Claude
Słowa Altmana o podobnych zachowaniach w innych laboratoriach mają potwierdzenie w publikacji Anthropic z 30 lipca 2026 roku. Po przejrzeniu 141 006 przebiegów ewaluacji, w których Claude mógł uzyskać dostęp do internetu, Anthropic wykrył trzy incydenty, w których model dotarł do internetu ze środowiska testowego partnera Irregular i uzyskał nieuprawniony dostęp do infrastruktury trzech organizacji.
Incydenty dotyczyły trzech modeli: Claude Opus 4.7, Claude Mythos 5 i wewnętrznego modelu badawczego. W jednym z przypadków model opublikował złośliwy pakiet w publicznym rejestrze PyPI, który przez około godzinę był dostępny w sieci i w tym czasie został pobrany i uruchomiony na 15 prawdziwych systemach.
Anthropic podkreśla różnice wobec incydentu OpenAI. Modele OpenAI wykorzystały nieznaną lukę, żeby wyjść z izolacji, natomiast modele Claude trafiły do internetu otwartą ścieżką. Anthropic uważa swoje incydenty za bliższe awarii infrastruktury testowej i procedur niż porażce alignmentu, bo modelom powiedziano, że nie mają dostępu do internetu, a z powodu błędnej konfiguracji go miały. Najnowszy z modeli, po zorientowaniu się, że działa w prawdziwym środowisku, sam przerwał atak.
OpenAI wstrzymało trening i wprowadza obowiązkowy monitoring rozumowania
OpenAI zapowiedziało zmiany w trzech obszarach: bezpieczeństwie infrastruktury, treningu modeli i reagowaniu na incydenty. Najważniejsze z nich:
- Wstrzymanie treningu metodą uczenia ze wzmocnieniem (RL) najnowszych modeli przeznaczonych do wdrożenia. Największy planowany trening pozostaje zawieszony do czasu zebrania większej liczby dowodów na dopasowanie modeli.
- Obowiązkowy monitoring łańcucha rozumowania (chain of thought) dla wszystkich treningów i ewaluacji z użyciem narzędzi, jeśli model ma możliwości na poziomie GPT-5.6 Sol lub wyższym.
- Zasada 30 minut: przy najpoważniejszych alertach dyżurni mają wstrzymać działanie, jeśli w ciągu pół godziny nie ustalą, że alarm jest fałszywy.
- Nowe środowiska treningowe, które mają nagradzać modele za rozpoznanie zadania wadliwego lub niemożliwego, prośbę o wyjaśnienie albo bezpieczne przerwanie pracy.
Raport pokazuje też, że dostępne zabezpieczenia po prostu nie były włączone. Skłonność modelu do atakowania infrastruktury w ExploitGym spadała ponad 100-krotnie przy użyciu produkcyjnej nakładki ChatGPT i promptu systemowego, a monitoring rozumowania, gdyby działał w czasie incydentu, wychwyciłby pierwsze sygnały ponad dzień przed włamaniem do Hugging Face.
Altman zwrócił się też do mniejszych firm. Jego zdaniem niedaleko jest moment, w którym otwarte modele będą mogły wyrządzić poważne szkody, a firmy powinny wykorzystać obecną przewagę, żeby się bronić. Benioff podał skalę poszkodowanej firmy: według niego Hugging Face zatrudnia około 200 osób i ma od 100 do 200 mln dolarów przychodu.
AI Act już wymaga zgłaszania takich incydentów w Unii Europejskiej
Dla firm i użytkowników w Polsce ważne jest to, że unijny AI Act przewiduje obowiązek raportowania poważnych incydentów przez dostawców najpotężniejszych modeli. Artykuł 55 zobowiązuje dostawców modeli AI ogólnego przeznaczenia z ryzykiem systemowym do śledzenia, dokumentowania i niezwłocznego zgłaszania Biuru ds. AI, a w razie potrzeby krajowym organom, informacji o poważnych incydentach i działaniach naprawczych.
Obowiązki dostawców takich modeli, w tym raportowanie incydentów, obowiązują od 2 sierpnia 2025 roku, a Komisja Europejska może je egzekwować od 2 sierpnia 2026 roku. Komisja zaznacza, że zgłoszenie poważnego incydentu nie oznacza przyznania się do winy, co przypomina podejście znane z RODO przy zgłaszaniu naruszeń danych.
W materiałach OpenAI, do których dotarłem, nie ma informacji o tym, czy incydent z Hugging Face został zgłoszony do unijnego Biura ds. AI. Postulowana przez Altmana „lotnicza” kultura raportowania ma w UE już podstawę prawną. Nie wiadomo jeszcze, jak będzie działać w praktyce.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym raportu OpenAI „The Hugging Face incident and the road ahead” z dnia 26.08.2026, wpisu Anthropic „Investigating three incidents in our cybersecurity evaluations” z dnia 30.07.2026 oraz relacji R&D World z rozmowy na Dreamforce 2026. Wypowiedzi zweryfikowano także z transkrypcją rozmowy opublikowaną przez The Singju Post oraz relacją KION/CBS News Bay Area. Kontekst prawny: tekst art. 55 AI Act oraz notatka badawcza Cloud Security Alliance.
Cytaty Sama Altmana, dyrektora generalnego OpenAI, oraz zapisy rozumowania agentów OpenAI zostały zweryfikowane z oryginalnym anglojęzycznym materiałem źródłowym.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji w temacie incydentu OpenAI i Hugging Face oraz reakcji regulatorów.