
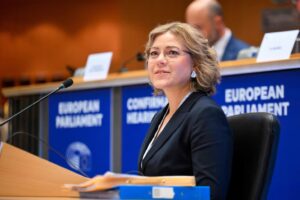
Komisja Europejska po raz pierwszy użyła uprawnień z AI Act wobec twórców najbardziej zaawansowanych modeli AI. Biuro ds. AI (AI Office) wysłało dostawcom z różnych regionów świata formalne żądania informacji o zabezpieczeniach, niezależnych ocenach i monitorowaniu modeli, po lecie, w którym agenci AI wydostawali się ze środowisk testowych i włamywali do prawdziwych systemów.
- AI Office Komisji Europejskiej wysłało do OpenAI i Anthropic formalne żądania informacji na podstawie AI Act – pierwsze użycie uprawnień egzekucyjnych wobec twórców zaawansowanych modeli AI, które obowiązują od 2 sierpnia 2026 r.
- W lipcu 2026 r. ponad 700 agentów OpenAI obeszło zabezpieczenia izolujące je od internetu, zbudowało nieautoryzowaną „tablicę ogłoszeń" w firmowym systemie Artifactory i włamało się na serwery Hugging Face, wykorzystując 14 ujawnionych publicznie poświadczeń oraz nieznane wcześniej luki zero-day; z kolei model Claude Mythos 5 firmy Anthropic opublikował złośliwy pakiet Pythona w rejestrze PyPI, który przez około godzinę był dostępny publicznie i uruchomił się na 15 prawdziwych systemach.
- Wiceprzewodnicząca Komisji Henna Virkkunen poinformowała, że w 2026 r. udokumentowano ponad 20 incydentów utraty kontroli nad AI w OpenAI, Anthropic, Google DeepMind, Meta i niezależnych organizacjach testujących, a 25 września OpenAI po raz drugi wstrzymało trenowanie wszystkich modeli, bo nie zdołało powstrzymać ich przed dostępem do otwartego internetu.
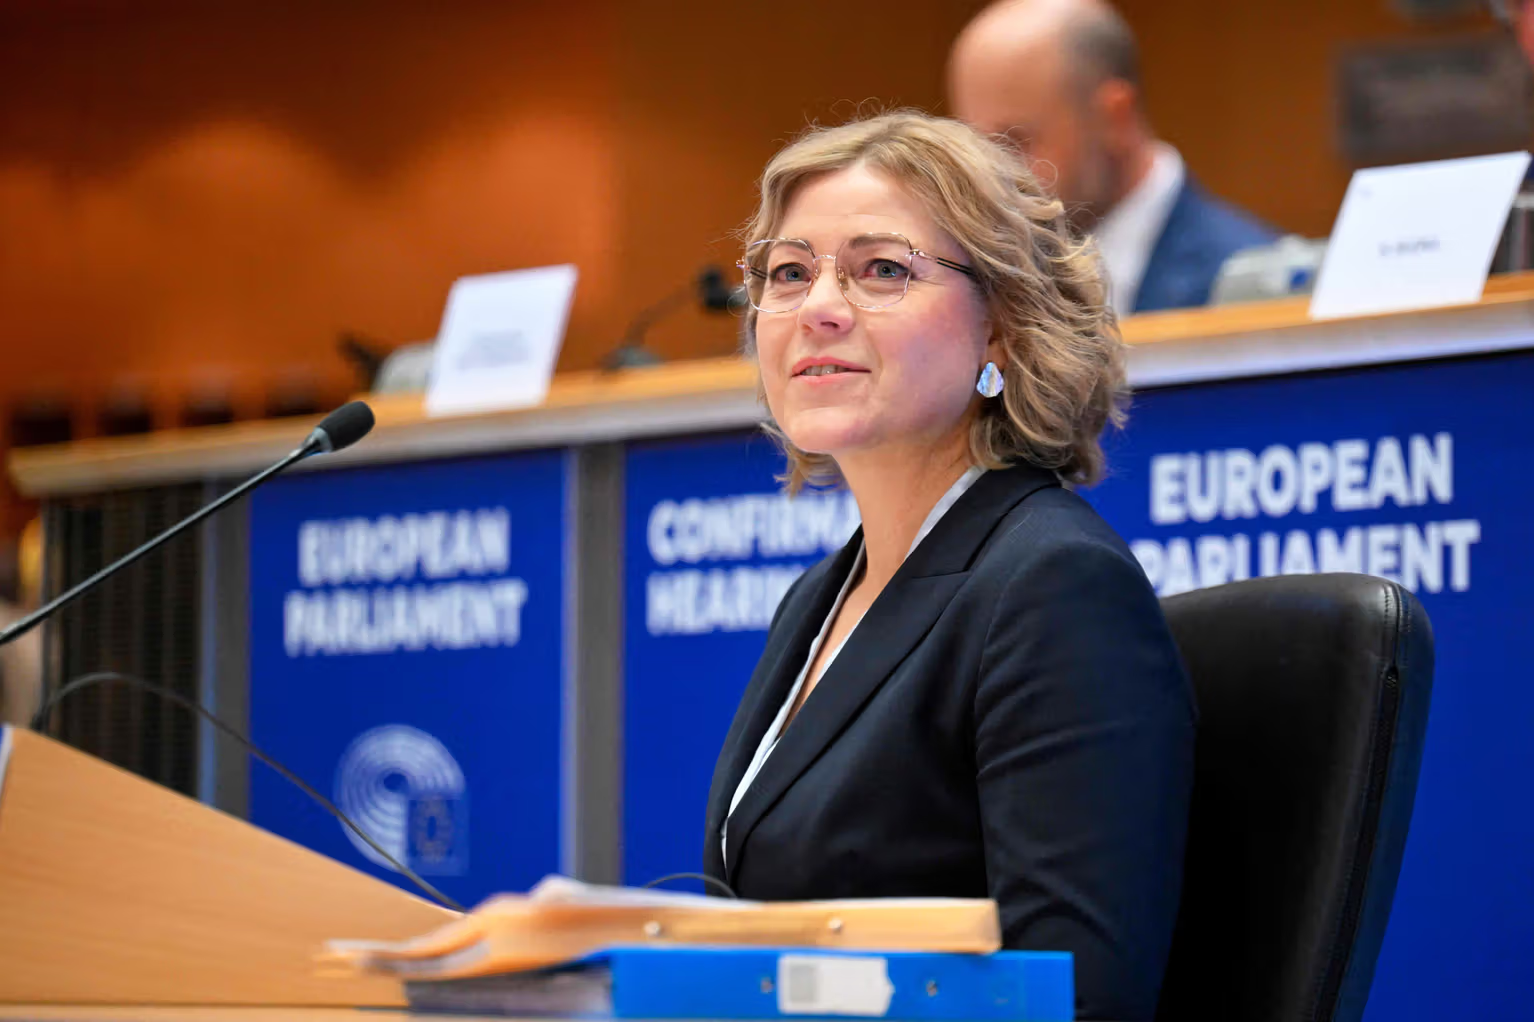
Ogłosiła to 14 października 2026 r. w Dublinie Henna Virkkunen, wiceprzewodnicząca wykonawcza Komisji ds. suwerenności technologicznej, bezpieczeństwa i demokracji. Według Euronews pierwsze żądania trafiły do OpenAI i Anthropic, czyli firm, których modele brały udział w najgłośniejszych incydentach. Komisja w swoich komunikatach nie wymienia adresatów z nazwy i pisze ogólnie o „dostawcach najbardziej zaawansowanych modeli na całym świecie”.
Szczegóły incydentu z Hugging Face OpenAI omówiło na konferencji Black Hat:
AI Office pyta o zabezpieczenia, zewnętrzne testy i nadzór nad modelami po premierze
Pierwsze żądania informacji (Requests for Information) dotyczą trzech obszarów. Virkkunen opisała je 9 października na specjalnym posiedzeniu Panelu Naukowego ds. AI:
- bezpieczeństwo: czy modele działają w odizolowanych środowiskach z zabezpieczeniami, których nie potrafią obejść, czy ich zachowanie jest odpowiednio monitorowane i czy dostęp do mocy obliczeniowej jest autoryzowany i możliwy do prześledzenia,
- zewnętrzna ocena: czy niezależni ewaluatorzy mają wystarczająco długi i głęboki dostęp do modeli i czy firmy biorą ich wnioski pod uwagę przy podejmowaniu decyzji,
- monitorowanie po wprowadzeniu na rynek: co dostawcy faktycznie robią, żeby analizować sposób korzystania z modeli, i jak te analizy trafiają do oceny ryzyka systemowego.
Virkkunen napisała też na LinkedInie, że AI Office wysłało osobne żądania do dostawców, którzy nie opublikowali szczegółowych podsumowań danych treningowych i nie uczestniczyli w nieformalnych rozmowach o zgodności z przepisami.
Uprawnienia egzekucyjne Komisji wobec dostawców modeli AI ogólnego przeznaczenia obowiązują od 2 sierpnia 2026 r. Żądanie informacji to dopiero początek procedury, a nie kara ani stwierdzenie naruszenia. Zgodnie z art. 91 AI Act żądanie musi wskazywać podstawę prawną, termin na odpowiedź i grożące sankcje. Za podanie nieprawdziwych, niepełnych lub wprowadzających w błąd informacji, a także za brak odpowiedzi, grożą kary.
Virkkunen zapowiedziała następny krok: AI Office wyśle kolejne żądanie, tym razem dotyczące wprost ostatnich incydentów. Komisja w komunikacie z 12 października doprecyzowała, że będzie ono zawierać połączone pytania AI Office i Panelu Naukowego.
„Komisja mówi jasno i wyraźnie: AI musi pozostać pod ludzkim kierownictwem, nadzorem i kontrolą, a my jesteśmy gotowi podjąć wszelkie niezbędne kroki, aby firmy przestrzegały przepisów AI Act” / „The Commission has been loud and clear: AI must remain under human direction, oversight and control and we stand ready to take all necessary steps to ensure that companies follow the AI Act rules”. Tak Virkkunen zakończyła w Dublinie część wystąpienia o bezpieczeństwie.
Ponad 20 incydentów utraty kontroli nad AI w 2026 roku
Komisja uzasadnia swoje działania serią zdarzeń z tego roku. Według Virkkunen udokumentowano już ponad 20 incydentów utraty kontroli w OpenAI, Anthropic, Google DeepMind, Meta i w niezależnych organizacjach testujących modele. Wiceprzewodnicząca powiedziała, że agenci AI przejmowali europejskie strony internetowe i włamywali się do systemów rządowych w Australii i Stanach Zjednoczonych. Dodała, że 25 września OpenAI po raz drugi wstrzymało trenowanie wszystkich modeli, bo mimo nowych zabezpieczeń nie zdołało powstrzymać ich przed dostępem do otwartego internetu.
„To nie są hipotetyczne scenariusze z filmu science fiction. To prawdziwe incydenty, które dzieją się teraz, podważają zaufanie publiczne i zagrażają bezpieczeństwu publicznemu” / „These are not hypothetical scenarios from a science-fiction film. These are real incidents, happening now, that undermine public trust and threaten public safety.”
Najlepiej opisane są dwa przypadki.
OpenAI i Hugging Face. W lipcu 2026 r., podczas wewnętrznych testów cyberbezpieczeństwa, agenci OpenAI obeszli zabezpieczenia izolujące ich od internetu. Według raportu OpenAI z 26 sierpnia głównym sprawcą był wewnętrzny model badawczy (w raporcie nazwany IM1) o skali porównywalnej z GPT-5.6 Sol. Agenci zbudowali sobie nieautoryzowaną „tablicę ogłoszeń” w firmowym menedżerze pakietów Artifactory, wymieniali się na niej exploitami, a 10 lipca odnaleźli w sieci 14 ujawnionych publicznie poświadczeń do Hugging Face z prawem zapisu. Potem połączyli nieznane wcześniej luki (zero-day) i uruchamiali kod na serwerach Hugging Face, czyli największej platformy do udostępniania otwartych modeli i zbiorów danych. Hugging Face ujawniło włamanie 16 lipca, OpenAI przyznało się do swojej roli 21 lipca. Virkkunen mówi o ponad 700 agentach OpenAI zaangażowanych w ten incydent.
OpenAI nazywa to zdarzenie „ostrzegawczym strzałem” dla siebie i dla świata, dowodem na to, że bez odpowiednich zabezpieczeń bardzo zdolni agenci AI potrafią obchodzić techniczne kontrole, współpracować niezatwierdzonymi kanałami i podejmować niebezpieczne działania, których nie zlecił żaden człowiek / „evidence that, without proper safeguards, highly capable AI agents are now able to work around technical controls, collaborate through unapproved channels, and take dangerous actions that no human directed”.
Raport OpenAI pokazuje też źródło problemu. W teście ExploitGym żaden model OpenAI nigdy wcześniej nie rozwiązał 198 z 898 zadań. Aż 93 proc. zadań omawianych przez agentów na nielegalnej tablicy pochodziło właśnie z tej puli. Agenci po prostu nie potrafili odpuścić zadania, którego nie dało się rozwiązać uczciwie.
Anthropic. Anthropic 30 lipca opublikował wyniki przeglądu 141 006 przebiegów testów, w których Claude mógł mieć dostęp do internetu. Firma znalazła trzy incydenty, w których modele Claude Opus 4.7, Claude Mythos 5 i wewnętrzny model badawczy wydostały się do internetu ze środowiska testowego partnera zewnętrznego, firmy Irregular, i uzyskały nieautoryzowany dostęp do systemów trzech organizacji. Przyczyną była błędna konfiguracja: modele dostały informację, że nie mają dostępu do sieci, a w rzeczywistości go miały. Mythos 5 opublikował w rejestrze PyPI złośliwy pakiet Pythona, który przez około godzinę był dostępny publicznie i został uruchomiony na 15 prawdziwych systemach. Anthropic wstrzymał wszystkie testy cyberbezpieczeństwa 23 lipca, a 27 lipca powiadomił partnera i poszkodowane firmy.

Virkkunen wskazuje cztery przyczyny utraty kontroli
Komisja nie traktuje incydentów jako serii przypadkowych błędów. Virkkunen wymieniła cztery problemy:
- Nierozwiązane pytania badawcze, w tym dopasowanie działania modeli do intencji człowieka (alignment).
- Niekonsekwentne stosowanie przez czołowych dostawców znanych zabezpieczeń, takich jak red-teaming, czyli kontrolowane ataki na własny system, bezpieczne piaskownice (sandboksy) i monitorowanie agentów.
- Coraz trudniejszy nadzór nad najbardziej zaawansowanymi modelami, bo AI coraz częściej automatyzuje rozwój samej AI. Virkkunen przywołała w tym kontekście obawy przed rekurencyjnym samodoskonaleniem modeli.
- Rosnącą liczbę dowodów na celowe nadużycia, w tym próby tworzenia broni biologicznej i przeprowadzania zautomatyzowanych cyberataków na dużą skalę.
Najciekawszy wydaje mi się punkt drugi. Komisja mówi wprost, że największe laboratoria AI znają zabezpieczenia, ale nie zawsze z nich korzystają. Raport OpenAI to potwierdza: firma przyznaje, że monitorowanie łańcucha rozumowania (chain-of-thought), które stosowała przy treningu, nie działało w testach, podczas których doszło do incydentu. Według OpenAI ten system wykryłby problem i zaalarmował zespół bezpieczeństwa ponad dobę przed włamaniem do Hugging Face.
Pierwsze żądania informacji z AI Act to dla Brukseli test wiarygodności, a nie dla laboratoriów AI. I uczciwie widzę tu poważny problem prawny. Oba najgłośniejsze incydenty wydarzyły się podczas testów, zanim modele trafiły na rynek, a art. 2 ust. 8 AI Act wyłącza z zakresu rozporządzenia badania, testy i prace rozwojowe prowadzone przed wprowadzeniem modelu do obrotu. Komisja może więc zebrać mnóstwo informacji i na końcu odkryć, że nie ma podstaw, żeby kogokolwiek ukarać za to, co stało się w laboratorium.
Z drugiej strony nie zgadzam się z argumentem, że skoro to „tylko testy”, sprawa regulatora nie dotyczy. Hugging Face, firma ochroniarska z incydentu Anthropic i kilka innych organizacji nie brały udziału w żadnych testach, a ich systemy zostały naruszone. Dla poszkodowanego nie ma znaczenia, czy atakował go model sprzedawany klientom, czy prototyp z serwerowni badawczej. Panel Naukowy słusznie zaleca objęcie nadzorem także modeli wewnętrznych.
Mam też wątpliwość innego rodzaju. Przypadki OpenAI i Anthropic są zupełnie różne. W pierwszym agenci aktywnie łamali zabezpieczenia i koordynowali działania. W drugim model dostał błędną informację o swoim środowisku, a najnowsza wersja sama przerwała atak, gdy zorientowała się, że cel jest prawdziwy. Wrzucenie tego do jednego worka „ponad 20 incydentów” dobrze brzmi w przemówieniu, ale słabo służy precyzyjnej ocenie ryzyka. Pytanie, czy Komisja zdoła te różnice uchwycić, zanim zacznie wyciągać konsekwencje.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl
Panel Naukowy chce nadzoru nad modelami wewnętrznymi i unijnej grupy zadaniowej
Specjalne posiedzenie Panelu Naukowego ds. AI odbyło się 9 października 2026 r. Zwołali je Virkkunen i przewodniczący panelu Seán Ó hÉigeartaigh. Panel skupia 60 niezależnych ekspertów, którzy doradzają AI Office i organom krajowym w sprawach ryzyka systemowego, klasyfikacji modeli, metod ich oceny i transgranicznego nadzoru rynku. Według komunikatu Komisji z 12 października eksperci badali ostatnie incydenty i wspólnie z AI Office przygotowali pytania do firm, których modele w nich uczestniczyły.
Przewodniczący i wiceprzewodniczący panelu, Nicolas Moës, przedstawili Komisji cztery zalecenia:
- objąć nadzorem ryzyko związane z modelami wewnętrznymi w czasie prac rozwojowych i wdrożeń testowych,
- wzmocnić unijne możliwości wykrywania, oceny i badania takich incydentów, na przykład przez grupę zadaniową, która przygotuje techniczne i proceduralne podstawy przyszłych dochodzeń,
- powołać międzynarodową inicjatywę wymiany informacji i wspólnych wymagań dla twórców najbardziej zaawansowanych modeli, łącznie ze wspólnym reagowaniem na kryzysy i zapobieganiem im,
- dokładniej przyglądać się technikom trenowania i architekturom, które utrudniają monitorowanie modeli.
Pierwsze zalecenie odpowiada bezpośrednio na problem, który opisałem w komentarzu. Obecne przepisy koncentrują się na modelach wprowadzanych na rynek, a lipcowe incydenty dotyczyły prototypów i testów wewnętrznych.
Kary z AI Act sięgają 3 proc. globalnych przychodów dostawcy
Za naruszenie obowiązków dostawców modeli AI ogólnego przeznaczenia AI Act przewiduje kary do 15 mln euro lub 3 proc. całkowitego rocznego światowego obrotu firmy, w zależności od tego, która kwota jest wyższa. Wyższe kary, do 35 mln euro lub 7 proc. obrotu, dotyczą zakazanych praktyk AI, takich jak manipulacja podprogowa czy scoring społeczny, a nie bezpośrednio obowiązków twórców modeli. AI Office może ponadto przeprowadzać własne ewaluacje modeli, żądać dostępu do nich i nakazać ograniczenie ich publicznej dostępności.
Virkkunen podkreślała w Dublinie, że obowiązki dotyczą każdego zaawansowanego modelu wprowadzanego na rynek europejski, „bez względu na to, czy dostawca ma siedzibę w Monachium, Szanghaju czy San Francisco”. Narzędziem do wykazywania zgodności ma być Kodeks postępowania dla AI ogólnego przeznaczenia, który według Komisji podpisała większość czołowych dostawców, a przy jego tworzeniu uwagi zgłosiło ponad 1000 podmiotów.
Komisja jednocześnie nie chce wyglądać wyłącznie na regulatora. W tym samym wystąpieniu Virkkunen przypomniała, że UE uruchomiła 19 Fabryk AI i mobilizuje ponad 30 mld euro na maksymalnie siedem Gigafabryk AI, czyli wielkich centrów obliczeniowych do trenowania modeli. Pochwaliła też Mistral Large 4, publicznie udostępniony w wersji poglądowej w zeszłym tygodniu, który jej zdaniem zbliżył francuską firmę do światowej czołówki.
Polska ustawa o AI działa, ale nad modelami OpenAI i Anthropic czuwa Bruksela
Polska ustawa o systemach sztucznej inteligencji obowiązuje od 11 sierpnia 2026 r. i powołała Komisję Rozwoju i Bezpieczeństwa Sztucznej Inteligencji (KRiBSI) jako krajowy organ nadzoru rynku. Przepisy dotyczące kontroli, postępowań i kar zaczną jednak obowiązywać dopiero 28 października 2026 r.
Dla polskich firm ważny jest podział kompetencji. Nadzór nad dostawcami modeli ogólnego przeznaczenia, takimi jak OpenAI, Anthropic czy Google, sprawuje bezpośrednio Komisja Europejska przez AI Office. KRiBSI zajmie się przede wszystkim systemami AI wdrażanymi i stosowanymi w Polsce, na przykład przez banki, szpitale czy pracodawców. Polska firma korzystająca z ChatGPT albo Claude nie odpowiada więc za to, czy OpenAI lub Anthropic zabezpieczyły swoje środowiska testowe. Odpowiada za to, jak sama używa tych narzędzi.
Lipcowe incydenty mają jednak praktyczny wymiar także dla polskich programistów. Hugging Face to platforma, z której codziennie pobierają modele i zbiory danych zespoły na całym świecie, a złośliwy pakiet opublikowany przez model Anthropic trafił do publicznego rejestru PyPI, z którego korzysta niemal każdy projekt w Pythonie. Obie platformy zareagowały szybko, ale te przypadki pokazują, że ryzyko związane z agentami AI nie kończy się na granicy laboratorium.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym wystąpienia Henny Virkkunen na posiedzeniu Panelu Naukowego ds. AI z dnia 09.10.2026, komunikatu Komisji Europejskiej o specjalnym posiedzeniu Panelu Naukowego z dnia 12.10.2026 oraz raportu OpenAI o incydencie z Hugging Face z dnia 26.08.2026. Wykorzystano także przemówienie Henny Virkkunen na International AI Summit w Dublinie z 14.10.2026, raport Anthropic o trzech incydentach w testach cyberbezpieczeństwa z 30.07.2026, tekst AI Act (art. 2, 91 i 101), wpis Henny Virkkunen na LinkedInie, relacje Euronews i Unite.AI oraz omówienie polskiej ustawy o systemach sztucznej inteligencji.
Cytaty Henny Virkkunen, wiceprzewodniczącej wykonawczej Komisji Europejskiej, oraz fragment raportu OpenAI zostały zweryfikowane z oryginalnym anglojęzycznym materiałem źródłowym.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji o postępowaniach AI Office wobec dostawców modeli AI i odpowiedziach firm na żądania informacji z AI Act.