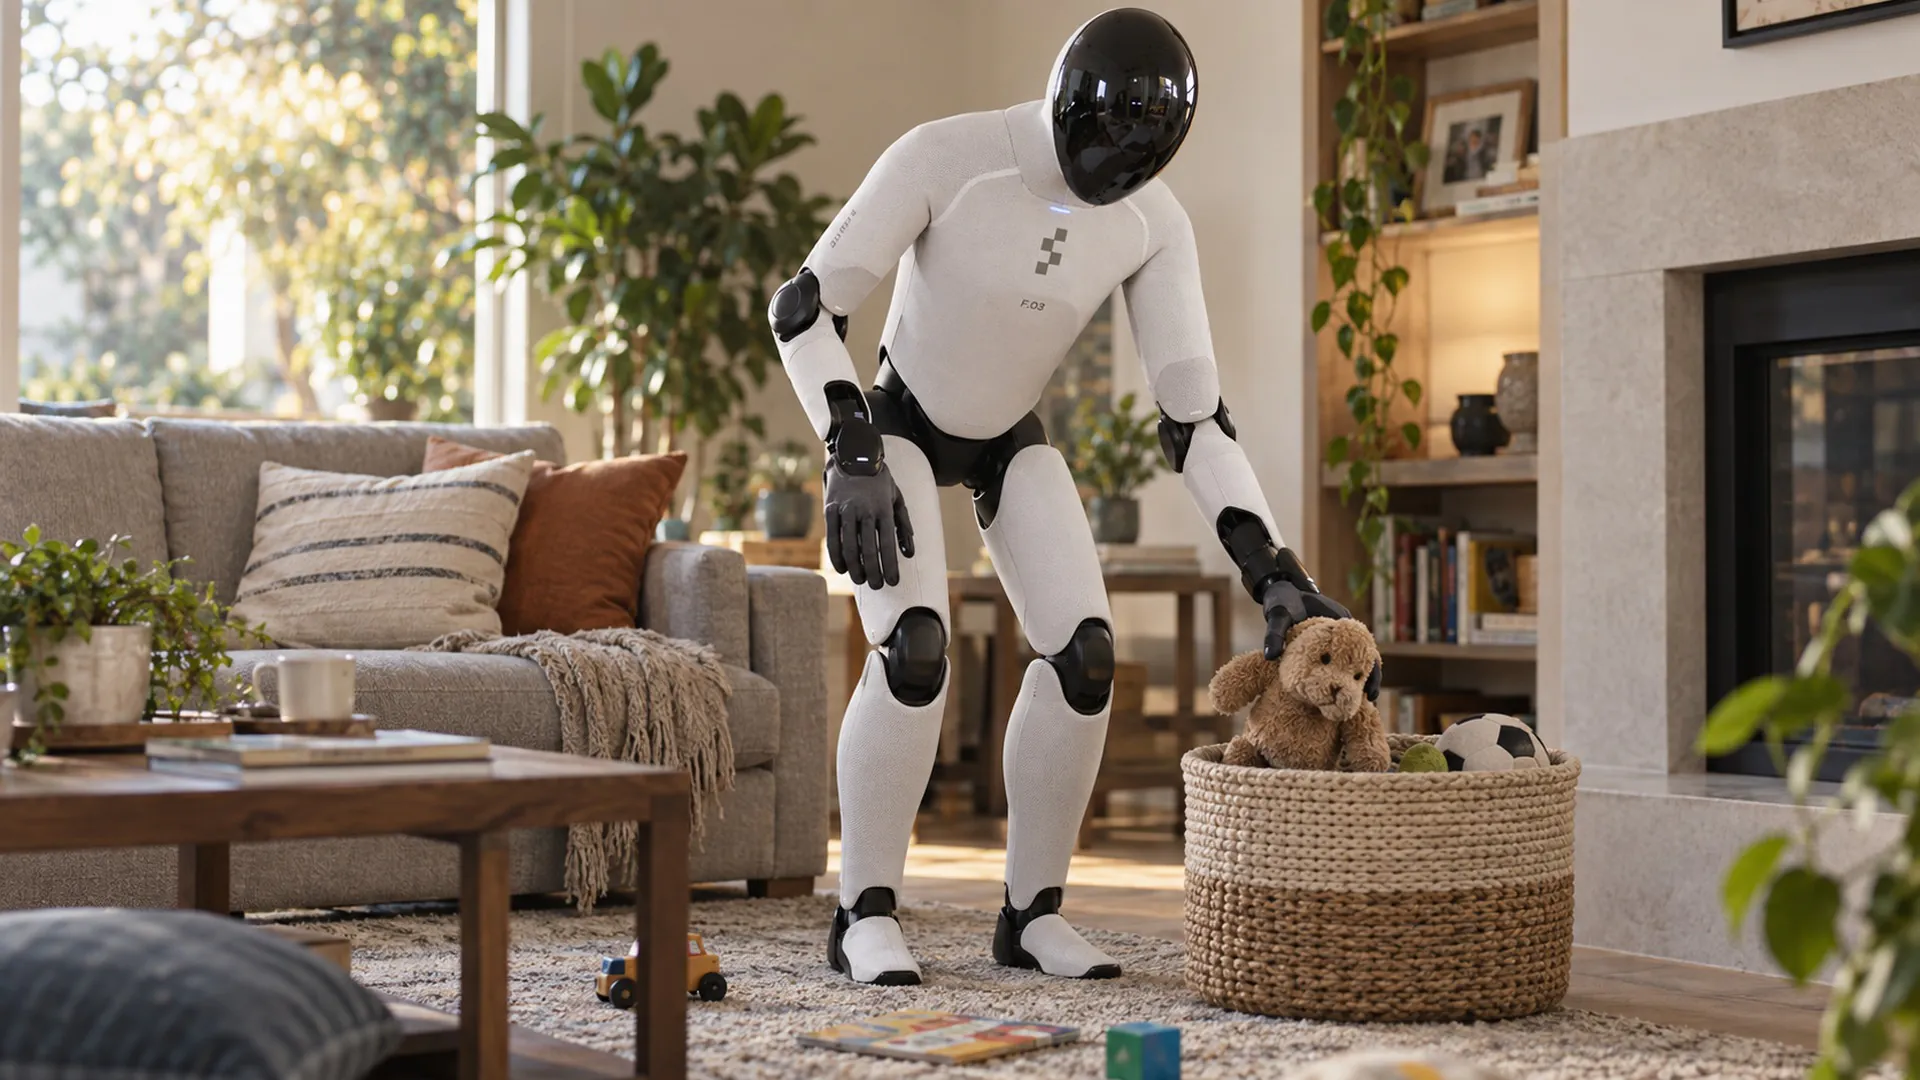
Figure przedstawiło 17 września 2026 roku Helix 2.5, sieć neuronową wytrenowaną wstępnie na Index, firmowym zbiorze nagrań ludzkiej pracy, i wysłało robota Figure 03 do 30 wynajętych domów w rejonie Zatoki San Francisco, w których wcześniej nie zebrano ani jednej klatki danych. Roboty ukończyły 237 z 420 prób, czyli 56 proc., podczas gdy identyczny model pozbawiony wstępnego trenowania na Index radził sobie w 9 proc. przypadków.
- Figure przedstawiło 17 września 2026 roku sieć neuronową Helix 2.5 i wysłało robota Figure 03 do 30 wynajętych domów w rejonie Zatoki San Francisco, gdzie ukończył 237 z 420 prób (56 proc.), podczas gdy identyczny model bez wstępnego trenowania na zbiorze Index radził sobie tylko w 9 proc. przypadków.
- W eksperymencie kontrolnym jedyną zmienną był wstępny trening na Index – Figure wytrenowało cztery modele na zagnieżdżonych podzbiorach danych i podaje, że przewidziało stratę testową największego z nich z dokładnością do czterech miejsc po przecinku jeszcze przed rozpoczęciem treningu, z błędem prognozy wynoszącym 0,54 proc. rozpiętości wyników.
- Przed wejściem humanoidów na rynek unijny stoi konkretna przeszkoda: rozporządzenie (UE) 2023/1230 w sprawie maszyn, stosowane od 20 stycznia 2027 roku, wymaga obowiązkowej oceny zgodności z udziałem jednostki notyfikowanej dla maszyn, których funkcje bezpieczeństwa opierają się na oprogramowaniu samouczącym się.
Pełny opis eksperymentu wraz z materiałami wideo z domów opublikowano na stronie Figure. Brett Adcock, założyciel i prezes Figure, udostępnił dodatkowo na X blisko czterogodzinny zapis pracy robotów, również z nieudanymi próbami, o czym poinformował serwis Humanoids Daily.
Here's 4 hours of our robot doing zero-shot work in 30 rental homes pic.twitter.com/LiKKBrU1ib
— Brett Adcock (@adcock_brett) September 17, 2026
Jeden zamrożony punkt kontrolny obsłużył wszystkie 30 domów
Figure użyło w każdym z 30 domów tego samego, niezmienianego punktu kontrolnego modelu dla każdego z trzech zadań. Żadne wagi nie były dostrajane do domów ani do przedmiotów użytych w ocenie, a wyniki prób nie posłużyły do wyboru punktu kontrolnego.
Robot Figure 03 wykonywał trzy prace: sprzątanie salonu, składanie ręczników i ścielenie łóżka. Firma zaznacza, że określenie „zero-shot” odnosi się wyłącznie do środowisk oceny i manipulowanych przedmiotów, bo same zachowania zostały wcześniej wyuczone na danych zebranych gdzie indziej. Żadna zabawka, ręcznik ani pościel użyte w teście nie pojawiły się w danych treningowych, co weryfikował model AI, a następnie człowiek. Roboty korzystały z mebli zastanych w każdym domu.
Kryteria oceny ustalono przed rozpoczęciem testów i nie przyznawano punktów cząstkowych:
- Sprzątanie salonu: wszystkie 13-15 zabawek rozrzuconych w pomieszczeniu musiało trafić do kosza, z limitem jednej minuty na zabawkę.
- Składanie ręczników: każdy ręcznik musiał zostać podniesiony, złożony i włożony do kosza, przy limicie trzech minut na sztukę. Jakość złożenia oceniano osobno, a najwyższa ocena wymagała zbliżenia wszystkich czterech rogów do siebie na odległość poniżej cala.
- Ścielenie łóżka: obie poduszki i oba rogi kołdry musiały znaleźć się w górnej jednej trzeciej łóżka, a kołdra miała zostać wygładzona.
- Każda interwencja człowieka podjęta ze względów bezpieczeństwa przerywała próbę i oznaczała ją jako nieudaną.
Rozbicie wyników na poszczególne zadania Figure pokazało na wykresie w komunikacie. Odczytał je serwis Humanoids Daily:
| Zadanie | Udane próby | Skuteczność |
|---|---|---|
| Ścielenie łóżka | 94/140 | 67 proc. |
| Składanie ręczników | 87/140 | 62 proc. |
| Zbieranie zabawek | 56/140 | 40 proc. |
| Łącznie | 237/420 | 56 proc. |
Najsłabiej wypadło więc zadanie pozornie najprostsze. Zbieranie zabawek wymaga przeszukania wielu powierzchni i ukończenia kilkunastu podniesień z rzędu, a wystarczy jedna porażka, żeby cała próba została zaliczona jako nieudana.
Wstępny trening na Index odpowiada za większość skuteczności Helix 2.5
Figure przeprowadziło eksperyment kontrolny, żeby oddzielić wpływ zbioru Index od wpływu samych danych opisujących zadania. Firma wytrenowała dwie polityki na identycznych danych zadaniowych: jedną od losowych wag, drugą od modelu Helix 2.5 wstępnie wytrenowanego na Index. Architektura, optymalizacja, hiperparametry, dane końcowe i procedura oceny pozostały bez zmian, więc jedyną zmienną był wstępny trening.
W ślepej ocenie model trenowany od zera ukończył 9 proc. prób, a model po treningu na Index 56 proc. Figure opisuje to jako ponad sześciokrotną różnicę i twierdzi, że skoro zmienna była jedna, luka mierzy bezpośrednio wkład Index. Firma dodaje, że żadne pojedyncze zadanie z testu nie stanowi więcej niż 1,90 proc. zbioru treningowego.
Humanoids Daily zwrócił uwagę na drobną rozbieżność w samym komunikacie: wykres Figure podaje dla modelu bazowego 35 udanych prób na 420, czyli około 8,3 proc., podczas gdy tekst mówi o 9 proc. Nie zmienia to skali różnicy, ale pokazuje, że nawet dobrze udokumentowany materiał firmowy warto czytać z ołówkiem.
Helix 2.5 został wytrenowany od losowej inicjalizacji wyłącznie na Index, inaczej niż poprzednik Helix 02, który startował z gotowego modelu wizyjno-językowego.

Figure twierdzi, że zmierzyło pierwsze prawo skalowania transferu człowiek-humanoid
Figure wytrenowało cztery modele na zagnieżdżonych podzbiorach Index obejmujących ośmiokrotny wzrost ilości danych, przy stałym rozmiarze modelu i niezmienionym treningu końcowym. Strata w przewidywaniu kolejnego ruchu robota spadała przewidywalnie z każdym podwojeniem danych.
Firma podaje, że korzystając wyłącznie z mniejszych przebiegów, przewidziała stratę testową największego z nich z dokładnością do czterech miejsc po przecinku jeszcze przed rozpoczęciem treningu, a błąd prognozy wyniósł 0,54 proc. rozpiętości wyników w całym ośmiokrotnym zakresie danych. Figure nazywa to, według swojej wiedzy, pierwszym prawem skalowania transferu człowiek-robot zmierzonym na humanoidzie.
Zastrzeżenie firma formułuje sama: pomiar dotyczy wyłącznie skalowania danych, a nie rozmiaru modelu, i mierzy stratę predykcyjną, a nie realną skuteczność w domu. To rozróżnienie ma znaczenie, bo przewidywalny spadek funkcji straty nie gwarantuje, że odsetek ukończonych prac domowych będzie rósł w tym samym tempie.
„Świętym Graalem robotyki jest zdolność do generalizacji” / „The holy grail for robotics is being able to generalize” napisał Brett Adcock w poście na LinkedIn, cytowanym przez serwis The AI Insider.
Tony Zhao z Sunday Robotics: liczy się nie tylko generalizacja, ale i niezawodność
Wynik Figure zakwestionował Tony Zhao, prezes i współzałożyciel Sunday Robotics, konkurencyjnej firmy budującej domowego robota Memo. We wpisie na X, przytoczonym przez Humanoids Daily, odniósł się do 237 udanych prób na 420 i opisał to jako porażkę w połowie przypadków.
„Wykonywanie użytecznej pracy = generalizacja + niezawodność” / „Doing useful work = generalization + reliability.”
Sunday Robotics ogłosiło 17 lipca 2026 roku model ACT-2 i podało, że Memo złożył 778 sztuk odzieży na 785 autonomicznych prób, czyli 99,1 proc., w dziewięciu kategoriach ubrań, w domach wcześniej niewidzianych i bez dostrajania do żadnego z nich.
Te dwie liczby nie są porównywalne i nie należy zestawiać ich wprost. Sunday liczy pojedyncze sztuki odzieży, Figure liczy ukończone w całości zadania obejmujące kilkanaście przedmiotów, ruch po mieszkaniu i pracę obiema rękami. Wynik Figure dla samych ręczników to 87 na 140, ale każda próba wymagała złożenia i odłożenia wszystkich ręczników. Obie oceny przeprowadziły zresztą same firmy, bez niezależnej weryfikacji.
Doceniam, jak Figure zbudowało ten eksperyment. Ślepa ocena, jedna zmienna, brak punktów cząstkowych i zaliczanie interwencji człowieka jako porażki to surowsze kryteria, niż stosuje większość firm robotycznych pokazujących efektowne demonstracje. Sprawdziłem opublikowany regulamin oceny i jest on bardziej szczegółowy niż w typowym komunikacie prasowym.
Mam natomiast dwa zastrzeżenia. Pierwsze dotyczy słowa „zero-shot”, które w tym materiale znaczy mniej, niż sugeruje nagłówek: nowe są domy i przedmioty, ale same zachowania robot poznał wcześniej na danych zebranych gdzie indziej. Drugie dotyczy tego, czego eksperyment nie mierzy. Domy były wynajęte i puste. W prawdziwym mieszkaniu jest pies, dziecko, przestawione krzesło i człowiek, który wchodzi do pokoju w środku zadania. Nie wiadomo, jak 56 proc. wygląda w takich warunkach.
Pytanie, które postawiłbym Figure, nie brzmi więc „czy robot poradzi sobie w nowym domu”, tylko „ile razy z rzędu poradzi sobie w tym samym domu przez tydzień”. Do tego momentu mówimy o bardzo dobrym wyniku badawczym, a nie o produkcie.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl
Index: 16 mln nagrań, 15 mln dolarów wypłat i 3,5 mld dolarów na moc obliczeniową
Index to zbiór danych, który Figure buduje przez aplikację płacącą ludziom za nagrywanie własnych codziennych czynności. Firma wyszła z nim z ukrycia 25 sierpnia 2026 roku i podała wtedy 264 tys. pobrań aplikacji w ponad 100 krajach, ponad 44 tys. aktywnych użytkowników tygodniowo, ponad 16 mln przesłanych nagrań oraz 15 mln dolarów wypłaconych twórcom danych. Na każde 1000 godzin zebranego materiału Index zawierał według Figure 373 unikalne zadania, 1146 unikalnych przedmiotów i 116 unikalnych środowisk.
W komunikacie o Helix 2.5 firma podaje, że Index generuje obecnie około 35 minut nowego ludzkiego doświadczenia na sekundę. Corey Lynch, dyrektor do spraw AI w Figure, mówi w materiale wideo, że do zbioru dokłada się tygodniowo ponad 90 tys. osób.
Skala inwestycji jest tu najbardziej wymownym wskaźnikiem. Figure zadeklarowało 3,5 mld dolarów przeznaczone na moc obliczeniową do trenowania Helix w ramach umowy z firmą Nscale. We wrześniu 2025 roku spółka pozyskała ponad miliard dolarów w rundzie serii C przy wycenie 39 mld dolarów po emisji i pozostaje prywatna. Jej robot Figure 03 powstaje w należącej do firmy fabryce BotQ i trafił dotąd między innymi do BMW Manufacturing.
Figure nie sprzedaje robotów klientom indywidualnym i nie ogłosiło daty takiej sprzedaży.
Kiedy taki robot mógłby legalnie trafić do polskiego mieszkania
Żaden humanoid Figure nie jest dostępny w Polsce ani nigdzie indziej poza programami firmowymi, a przed wejściem takiej maszyny na rynek unijny stoi konkretna przeszkoda regulacyjna. Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2023/1230 w sprawie maszyn zastępuje dyrektywę 2006/42/WE i jest stosowane od 20 stycznia 2027 roku, bezpośrednio we wszystkich państwach członkowskich, bez okresu przejściowego i bez potrzeby wdrożenia do prawa krajowego.
Dla robota domowego sterowanego siecią neuronową ma to bardzo praktyczne konsekwencje. Rozporządzenie wprowadza do załącznika I części A maszyny, w których funkcje bezpieczeństwa opierają się na oprogramowaniu samouczącym się. Taka maszyna wymaga obowiązkowej oceny zgodności z udziałem jednostki notyfikowanej, nawet jeśli producent stosuje normy zharmonizowane. Do tego dochodzą wymagania dotyczące odporności na ingerencję z zewnątrz oraz obowiązki związane ze wsparciem aktualizacji oprogramowania. Rozporządzenie maszynowe ma działać równolegle do AI Act, unijnego rozporządzenia o sztucznej inteligencji, które zajmuje się ryzykami samego systemu AI, podczas gdy przepisy maszynowe odpowiadają za bezpieczeństwo maszyny jako całości.
Polski nabywca takiego robota, czy to gospodarstwo domowe, czy firma sprzątająca, zderzy się więc najpierw nie z ceną i nie ze skutecznością 56 proc., tylko z pytaniem, czy producent ma dokumentację i deklarację zgodności UE według nowego rozporządzenia. Dla amerykańskich firm robotycznych, które dziś optymalizują komunikaty pod inwestorów, to osobna i kosztowna ścieżka.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym oficjalnego komunikatu Figure z dnia 17.09.2026 wraz z załącznikiem opisującym kryteria oceny, wcześniejszego komunikatu Figure o zbiorze Index z dnia 25.08.2026 oraz analizy serwisu Humanoids Daily, z której pochodzi odczyt rozbicia wyników na poszczególne zadania i relacja z wpisu Tony’ego Zhao. Kontekst regulacyjny opracowano na podstawie rozporządzenia (UE) 2023/1230, opisanego między innymi przez Multicert. Do weryfikacji wykorzystano również materiały serwisów Unite.AI, The AI Insider i humanoid.guide.
Cytaty Bretta Adcocka, założyciela i prezesa Figure, oraz Tony’ego Zhao, prezesa i współzałożyciela Sunday Robotics, zostały zweryfikowane z oryginalnym anglojęzycznym materiałem źródłowym w zakresie dostępnym publicznie. Oba pochodzą z wpisów w mediach społecznościowych relacjonowanych przez wskazane redakcje.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji o modelu Helix 2.5, wynikach niezależnych testów oraz planach Figure wobec rynku konsumenckiego.