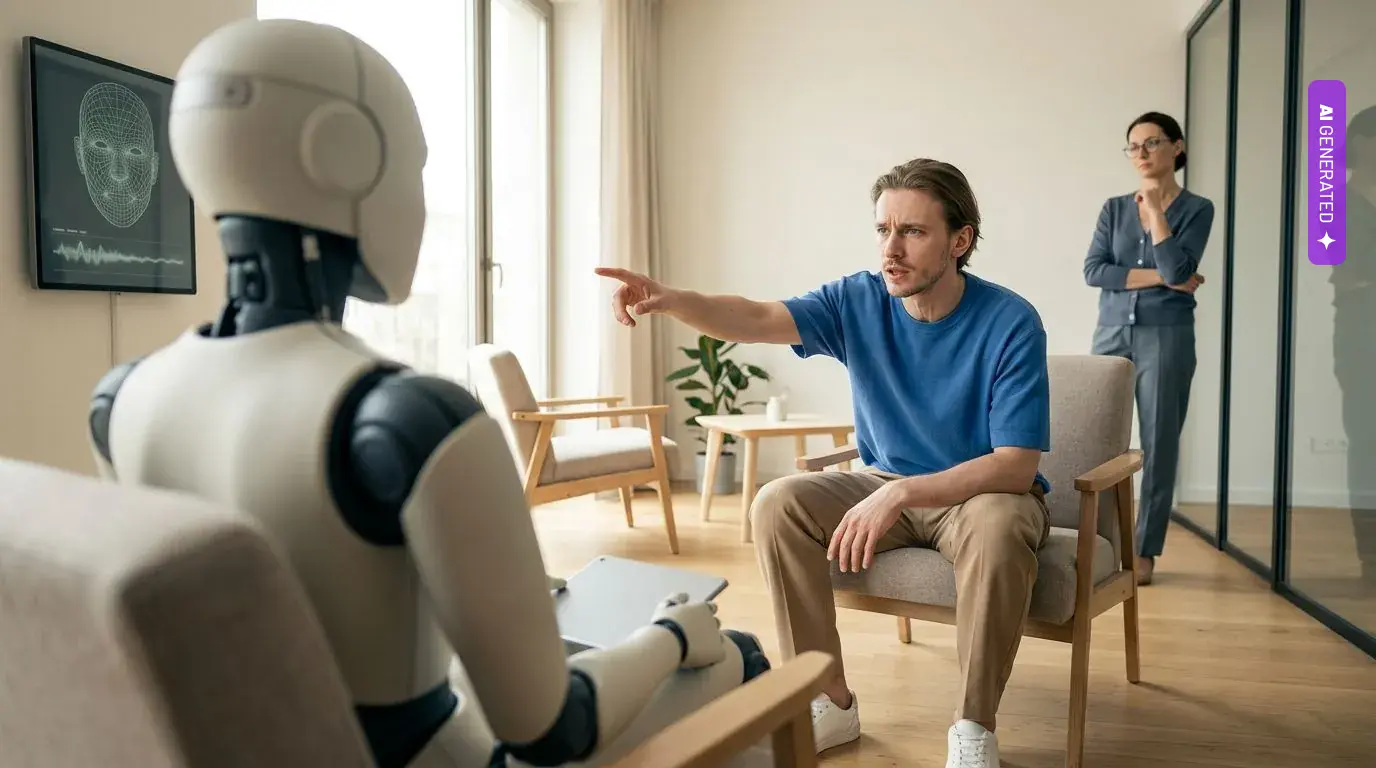
System zbudowany przez naukowców z UTHealth Houston i Yale School of Medicine na otwartym modelu Qwen3-Omni wykrył mniej niż połowę objawów psychiatrycznych, które zidentyfikowały zespoły lekarzy: jego czułość wyniosła 0,45 wobec panelu z UTHealth i 0,50 wobec panelu z Yale. W domenie percepcji, obejmującej halucynacje, model nie wskazał ani jednego przypadku patologii, mimo że symulowani pacjenci mówili o swoich omamach wprost.
- System zbudowany na modelu Qwen3-Omni-30B-A3B-Thinking wykrył mniej niż połowę objawów psychiatrycznych zidentyfikowanych przez ekspertów – jego czułość wyniosła 0,45 wobec panelu z UTHealth Houston i 0,50 wobec panelu z Yale School of Medicine, a w domenie percepcji (obejmującej halucynacje) nie wskazał ani jednego przypadku patologii.
- Zgodność modelu z ekspertami spadała monotonicznie wraz z nasileniem objawów: wobec panelu z Yale trafność wynosiła 87,1 proc. przy najłagodniejszej prezentacji (T0), a zaledwie 72,7 proc. przy najcięższej (T2), co oznacza spadek o blisko 15 punktów procentowych.
- Kwantyzacja modelu do formatu INT4 – zmniejszająca jego rozmiar z około 60 GB do około 19 GB – spowodowała spadek współczynnika zgodności AC1 z 0,72 do 0,44 wobec panelu Yale, przy czym domeny wymagające wnioskowania straciły średnio 19,2 punktu procentowego trafności, podczas gdy domeny obserwacyjne tylko 10,5 punktu.
Badanie opublikowano 14 września 2026 roku w czasopiśmie „npj Mental Health Research” wydawanym przez Nature Portfolio. Pierwszymi autorami są Benson Mwangi i Hammza Jabbar Abdl Sattar Hamoudi z Department of Psychiatry and Behavioral Sciences w McGovern Medical School na UTHealth Houston, autorem seniorem jest Cesar A. Soutullo, kierownik psychiatrii dzieci i młodzieży w tej samej jednostce. Ze strony Yale School of Medicine współautorem jest Andrés Martin z Child Study Center.
Dziewięć nagrań, 396 pojedynczych ocen i dwa niezależne panele psychiatrów
Zespół nie testował modelu na prawdziwych pacjentach. Materiałem było dziewięć nagrań wideo, każde krótsze niż trzy minuty, z profesjonalnymi aktorami odgrywającymi role tak zwanych standaryzowanych pacjentów. Nagrania pochodzą z recenzowanego zbioru edukacyjnego opublikowanego przez Martina i współpracowników w 2020 roku w MedEdPORTAL.
Troje symulowanych pacjentów przedstawiało schizofrenię, zaburzenie obsesyjno-kompulsyjne (OCD) i chorobę afektywną dwubiegunową. Każdy przypadek nagrano w trzech momentach (T0, T1, T2) o rosnącym nasileniu objawów. Dla każdego nagrania oceniano 44 pozycje w systemie „obecne / nieobecne”, co dało 396 pojedynczych klasyfikacji w dziesięciu domenach badania stanu psychicznego (Mental Status Examination, MSE): afekt i nastrój, wygląd i zachowanie, percepcja, mowa, ryzyko samobójcze, urojenia, obsesje, kompulsje oraz spójność i tempo procesu myślowego.
Nagrania niezależnie ocenili eksperci z dwóch ośrodków. Panel z Yale składał się z psychiatry, specjalisty pielęgniarstwa psychiatrycznego, rezydenta psychiatrii i studenta ostatniego roku medycyny. Panel z UTHealth tworzyli psychiatra dzieci i młodzieży z doświadczeniem w diagnostyce dorosłych, fellow oraz rezydent psychiatrii, zaślepieni wobec ocen z Yale.
Sam model to Qwen3-Omni-30B-A3B-Thinking, otwarty model multimodalny wypuszczony przez zespół Qwen należący do Alibaby we wrześniu 2025 roku na licencji Apache 2.0. Ma 30 mld parametrów, z czego około 3 mld aktywnych przy pojedynczym kroku wnioskowania. Naukowcy uruchomili go lokalnie na jednej karcie NVIDIA RTX Blackwell z 96 GB pamięci i owinęli własnym, trzyfazowym potokiem: nagranie dzielone na 30-sekundowe fragmenty z 10-sekundowym zakładem, mechanizm pamięci przenoszący streszczenia poprzednich fragmentów, a na końcu metaanaliza tekstowa i osobny ślad decyzyjny. Model działał w trybie zero-shot, bez douczania na danych klinicznych.
Model przeceniał to, co widać, i nie zauważał tego, o czym pacjent mówił
Podstawowy wynik badania to nie ogólna trafność, tylko struktura błędów. Zgodność między dwoma panelami psychiatrów wyniosła AC1 = 0,87 (współczynnik Gweta, odporny na niską częstość patologii w próbie), a zgodność modelu z ekspertami tylko 0,70 wobec UTHealth i 0,72 wobec Yale. Ogólna swoistość modelu była wysoka (0,86 i 0,87), ale czułość zatrzymała się na 0,45 i 0,50.
Autorzy nazwali tę rozbieżność „luką w rozumowaniu klinicznym” (clinical reasoning gap). Model dobrze radził sobie tam, gdzie objaw widać albo słychać, i zawodził tam, gdzie trzeba wywnioskować go z relacji pacjenta.
| Domena MSE | Czułość (UTHealth / Yale) | Swoistość (UTHealth / Yale) |
|---|---|---|
| Afekt i nastrój | 0,91 / 1,00 | 0,68 / 0,67 |
| Mowa | 0,78 / 0,88 | 0,52 / 0,54 |
| Obsesje | 0,50 / 0,29 | wysoka |
| Urojenia | 0,12 / 0,17 | bliska maksimum |
| Percepcja | 0,00 / 0,00 | 1,00 |
| Ryzyko samobójcze | 1,00 / 1,00 | wysoka |
W domenach obserwowalnych model zgłaszał patologię zbyt często. W mowie wskazywał objaw w 55,6 proc. pozycji, podczas gdy eksperci oznaczali patologię w 25,0 proc. (UTHealth) i 22,2 proc. (Yale). W afekcie i nastroju model wskazywał 46,7 proc. wobec 24,4 i 20,0 proc. u ekspertów. Efekt był taki, że w trzech domenach trafność modelu spadła poniżej albo blisko progu, jaki osiągnąłby prosty klasyfikator odpowiadający „brak objawu” przy każdej pozycji: mowa 61 proc., wygląd i zachowanie 66,7 proc., afekt i nastrój 73,3 proc.
W domenach wymagających wnioskowania wzór się odwrócił. W percepcji eksperci oznaczyli patologię w 8,3 proc. (UTHealth) i 5,6 proc. (Yale) pozycji, a model nie wskazał jej ani razu. Audyt śladów rozumowania przeprowadzony przez doświadczonego psychiatrę pokazał, dlaczego: model poprawnie transkrybował wypowiedzi pacjentów o doświadczeniach omamowych, ale nie potrafił przypisać tej treści do kategorii zaburzenia spostrzegania. W urojeniach czułość wyniosła 0,12 i 0,17.
Jednym wyjątkiem było ryzyko samobójcze, gdzie model osiągnął stuprocentową czułość wobec obu paneli. Autorzy tłumaczą to tym, że w tym zbiorze ocena opierała się na jednej jednoznacznej wypowiedzi pacjenta, więc zadanie było w praktyce obserwacyjne, a nie wnioskowe.
Autorzy badania piszą wprost, że model nie nadaje się do pracy bez nadzoru
W tekście naukowym pojawia się zdanie, którego nie ma w komunikacie prasowym: czułość na poziomie 0,45-0,50 oznacza, że model pomija ponad połowę patologii zidentyfikowanej przez ekspertów, co czyni go „obecnie niewystarczającym do wdrożenia bez nadzoru” / „currently insufficient for unsupervised deployment”.
Komunikat prasowy UTHealth Houston z 16 września 2026 roku prowadzi czytelnika w inną stronę. Jego tytuł mówi o narzędziu zbliżającym się do poziomu psychiatry, a Hammza Hamoudi jest w nim cytowany jako autor stwierdzenia, że zbudowane narzędzie wykonuje ocenę diagnostyczną prawie tak dobrze jak zespół psychiatrów, i że wynik jest imponujący. Benson Mwangi w tym samym materiale przyznaje, że model był równie dobry w obserwacjach, ale słabszy w domenach wymagających rozumowania, które wykonuje psychiatra, i dodaje, że nawet jego błędy mogą posłużyć jako materiał dydaktyczny dla studentów.
Cesar Soutullo formułuje cel projektu jako uzupełnienie, a nie zastąpienie pracy lekarza:
„Po co wybierać jedno? Można korzystać z obu.” / „Why pick one? You can use both.”
To właśnie z tego komunikatu prasowego, a nie z samego artykułu naukowego, korzystała większość publikacji opisujących badanie, w tym teksty polskie. Wersja prasowa jest prawdziwa, ale pomija tę część wyników, która jest najbardziej niewygodna dla tezy o dorównywaniu psychiatrom.
Zestawienie komunikatu prasowego z pracą naukową jest tutaj lekcją samą w sobie. Uczelnia napisała, że narzędzie zbliża się do poziomu psychiatry, i formalnie miała rację, bo ogólny profil predykcji modelu rzeczywiście przypominał ekspercki. Tylko że ta równowaga na poziomie zagregowanym powstała przez zsumowanie dwóch przeciwstawnych błędów: nadmiaru rozpoznań tam, gdzie objaw widać, i niedomiaru tam, gdzie trzeba go wywnioskować. Uśrednienie ukryło jedno i drugie.
Najbardziej niepokoi mnie proponowany scenariusz wdrożenia. Soutullo mówi o pediatrze pracującym samodzielnie w oddalonym regionie, który dostałby od modelu „drugie spojrzenie”. Rozumiem intencję i uważam ją za sensowną, ale to jest dokładnie ten kontekst, w którym fałszywie ujemny wynik kosztuje najwięcej. Lekarz bez szkolenia psychiatrycznego nie ma jak skorygować modelu, który przy urojeniach ma czułość 0,12, a przy zaburzeniach spostrzegania zero. Narzędzie, które nie podnosi alarmu, jest w takiej sytuacji gorsze niż brak narzędzia, bo daje fałszywe poczucie sprawdzenia.
Jednocześnie uważam, że najcenniejszy jest tu wkład metodologiczny, a nie sam model. Pokazanie, że rozbieżność między ekspertami to mierzalna właściwość badania psychiatrycznego, a nie szum do wyczyszczenia, jest ustaleniem, które przeżyje kolejne generacje modeli. Qwen3-Omni za rok będzie przestarzały. Ramka porównawcza z dwoma niezależnymi panelami zostanie.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl

Im cięższe objawy, tym większy błąd modelu
Zgodność modelu z ekspertami spadała monotonicznie wraz z nasileniem objawów w kolejnych wizytach. Wobec panelu z UTHealth trafność wyniosła 84,8 proc. przy T0, 80,3 proc. przy T1 i 71,2 proc. przy T2. Wobec Yale odpowiednio 87,1 proc., 81,8 proc. i 72,7 proc. To spadek o 13-14 punktów procentowych między najłagodniejszą a najcięższą prezentacją kliniczną.
Zgodność między samymi psychiatrami zachowała się inaczej: 96,2 proc. przy T0, potem 87,9 proc. przy T1 i tyle samo przy T2, mimo dalszego wzrostu częstości patologii. Autorzy wskazują, że część spadku modelu wynika po prostu z większej liczby okazji do pomyłki, ale czułość modelu nie poprawiła się mimo rosnącej liczby objawów do wykrycia, co według nich świadczy o ograniczeniu w samym rozumowaniu, a nie o artefakcie statystycznym.
Osobne ustalenie dotyczy tego, gdzie model się myli. Na 396 pozycji panele ekspertów zgodziły się w 359 przypadkach (90,7 proc.) i różniły w 37 (9,3 proc.). Tam, gdzie lekarze byli zgodni, model mylił się w 17 proc. przypadków. Tam, gdzie lekarze się różnili, odsetek błędów modelu wzrósł do 41 proc. wobec konsensusu z Yale i 59 proc. wobec UTHealth, czyli 2,3 i 3,4 razy.
Model radził sobie też bardzo różnie w zależności od rozpoznania:
- choroba afektywna dwubiegunowa (pacjent „Robbin”): trafność 84,1 proc. wobec UTHealth i 87,1 proc. wobec Yale, czułość 0,78 i 0,82,
- schizofrenia (pacjent „Karthik”): 78,0 proc. i 78,8 proc., czułość 0,41 i 0,43,
- OCD (pacjent „Ben”): 74,2 proc. i 75,8 proc., czułość 0,20 i 0,22.
Układ ten pokrywa się z główną hipotezą autorów. Mania ma wyraźne objawy ruchowe i afektywne dostępne dla analizy audiowizualnej, natomiast patologia w OCD mieści się w treści myśli, o której trzeba wnioskować z tego, co pacjent mówi.
Kompresja modelu do 4 bitów najmocniej uderzyła w zdolność wnioskowania
Badacze powtórzyli całą analizę na skwantyzowanej wersji modelu, żeby sprawdzić, na ile rozumowanie kliniczne zależy od surowej pojemności parametrycznej. Kwantyzacja INT4 sprowadziła artefakt z około 60 GB do około 19 GB, czyli do rozmiaru, który mieści się na znacznie tańszym sprzęcie.
Efekt był dotkliwy. Wobec panelu z Yale trafność spadła z 80,6 do 66,8 proc., a współczynnik AC1 z 0,72 do 0,44. Odsetek pozycji oznaczonych jako patologia wzrósł z 19,4 do 40,3 proc., przy eksperckiej częstości 17,2 proc., a test McNemara stał się wysoko istotny (p < 0,0001), co potwierdza systematyczne nadrozpoznawanie.
Degradacja rozłożyła się nierówno. Domeny wymagające wnioskowania straciły średnio 19,2 punktu procentowego trafności (spójność procesu myślowego z 88,9 do 57,1 proc., ocena ryzyka samobójczego z 94,4 do 61,1 proc., urojenia z 86,7 do 64,4 proc.), a domeny obserwacyjne średnio 10,5 punktu. Autorzy zaznaczają, że alternatywne wyjaśnienia, na przykład większa wrażliwość domen o niskiej częstości patologii na szum kwantyzacyjny, nie zostały wykluczone.
Dla każdego, kto planuje uruchamianie modeli medycznych lokalnie, to najbardziej praktyczny wniosek z całej pracy. Oszczędność na VRAM nie jest neutralna dla jakości klinicznej i uderza najmocniej dokładnie tam, gdzie błąd jest najgroźniejszy.
Co badanie oznacza dla polskich szpitali i dla obowiązków z AI Act
Gdyby system tego typu miał trafić do polskiej placówki, nie byłby zwykłym narzędziem informatycznym. Oprogramowanie, które ma wspierać ocenę diagnostyczną, podlega w Unii rozporządzeniu 2017/745 (MDR) jako wyrób medyczny, a na mocy art. 6 ust. 1 AI Act sztuczna inteligencja wbudowana w wyrób objęty prawodawstwem harmonizacyjnym z załącznika I jest automatycznie klasyfikowana jako system wysokiego ryzyka.
Harmonogram zmieniło rozporządzenie 2026/1744, czyli pakiet Digital Omnibus on AI, które weszło w życie 27 lipca 2026 roku. Obowiązki dla samodzielnych systemów wysokiego ryzyka z załącznika III przesunięto na 2 grudnia 2027 roku, a dla systemów stanowiących element produktów z załącznika I, w tym wyrobów medycznych, na 2 sierpnia 2028 roku. Przepisy o przejrzystości z art. 50 AI Act obowiązują natomiast od 2 sierpnia 2026 roku, a więc pacjent w polskiej placówce już dziś powinien wiedzieć, kiedy rozmawia z systemem, a nie z człowiekiem.
Kontekst kadrowy sprawia, że pokusa sięgnięcia po takie narzędzia będzie w Polsce silna. Według danych Ministerstwa Zdrowia, przytoczonych przez portal Medycyna Praktyczna, liczba lekarzy ze specjalizacją z psychiatrii dzieci i młodzieży wzrosła z 415 w 2015 roku (374 wykonujących zawód) do 573 w 2023 roku (546 wykonujących zawód). To wzrost o niecałe 40 proc. w osiem lat, przy znacznie szybszym przyroście liczby pacjentów w tym okresie.
Badanie z UTHealth i Yale nie podważa sensu wykorzystania AI w tym kontekście, ale wskazuje, w której roli ma ona dziś pokrycie w danych. Autorzy proponują etapową ścieżkę wdrożenia: domeny obserwacyjne, gdzie model wykazuje wysoką czułość, nadają się ich zdaniem do integracji jako narzędzie sygnalizujące lekarzowi potencjalne nieprawidłowości afektywne lub psychomotoryczne do weryfikacji, analogicznie do systemów przesiewowych w radiologii. Domeny wymagające wnioskowania wymagają natomiast, według tych samych autorów, dalszego rozwoju technologicznego przed jakimkolwiek zastosowaniem klinicznym.
Ograniczenia, o których trzeba pamiętać przy czytaniu wyników
Autorzy sami wymieniają ich sporo i część z nich działa na niekorzyść modelu bardziej, niż sugerują liczby. Nagrania odgrywali aktorzy według scenariusza, więc prezentacje mogły być bardziej stereotypowe niż w prawdziwym gabinecie. Prawdziwi pacjenci częściej nie mają wglądu w chorobę albo aktywnie ukrywają treści urojeniowe, co oznacza, że zaobserwowane niedowykrywanie jest prawdopodobnie szacunkiem ostrożnym, a nie zawyżonym.
W drugą stronę działa fakt, że model pracował w informacyjnej próżni, bez wywiadu, historii leczenia i danych o lekach, którymi rutynowo dysponuje lekarz. Zbiór jest też mały: dziewięć nagrań, 396 klasyfikacji, trzy rozpoznania, po jednym pacjencie na rozpoznanie i wąski przedział wiekowy. Oba panele stosowały uzgadnianie ocen, więc końcowe oceny są pozycjami wynegocjowanymi, co mogło zawyżyć zgodność ekspercką.
Osobnym zastrzeżeniem jest brak modelu porównawczego. Zespół nie zestawił Qwen3-Omni z modelem tekstowym ani z komercyjnym rozwiązaniem zamkniętym, więc nie wiadomo, na ile wyniki opisują ten konkretny model, a na ile całą obecną klasę multimodalnych modeli bazowych. Autorzy wskazują też, że nagrania i arkusze ocen są publicznie dostępnym materiałem dydaktycznym, więc nie da się całkowicie wykluczyć ich obecności w danych treningowych, choć bardzo specyficzny, domenowy rozkład błędów przemawia ich zdaniem przeciwko prostemu odtwarzaniu zapamiętanych odpowiedzi.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz źródeł pierwotnych, w tym badania Human vs AI clinical assessment: benchmarking a multimodal foundation model against multi-center expert judgment on the mental status examination, opublikowanego 14.09.2026 w „npj Mental Health Research” (DOI: 10.1038/s44184-026-00245-y), komunikatu prasowego UTHealth Houston z dnia 16.09.2026 oraz pełnej wersji preprintu na medRxiv, z którego pochodzą szczegółowe dane o czułości, swoistości i analizie kwantyzacji.
Kontekst regulacyjny zweryfikowano na podstawie opracowania Krajowej Izby Radców Prawnych dotyczącego zmian w harmonogramie AI Act wprowadzonych rozporządzeniem 2026/1744. Dane o liczbie lekarzy ze specjalizacją z psychiatrii dzieci i młodzieży pochodzą z informacji Ministerstwa Zdrowia przytoczonej przez portal Medycyna Praktyczna.
Cytaty Cesara Soutullo (autor senior badania, McGovern Medical School, UTHealth Houston) oraz fragment pracy naukowej zostały zweryfikowane z oryginalnym anglojęzycznym materiałem źródłowym.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji na temat walidacji multimodalnych modeli AI w diagnostyce psychiatrycznej.