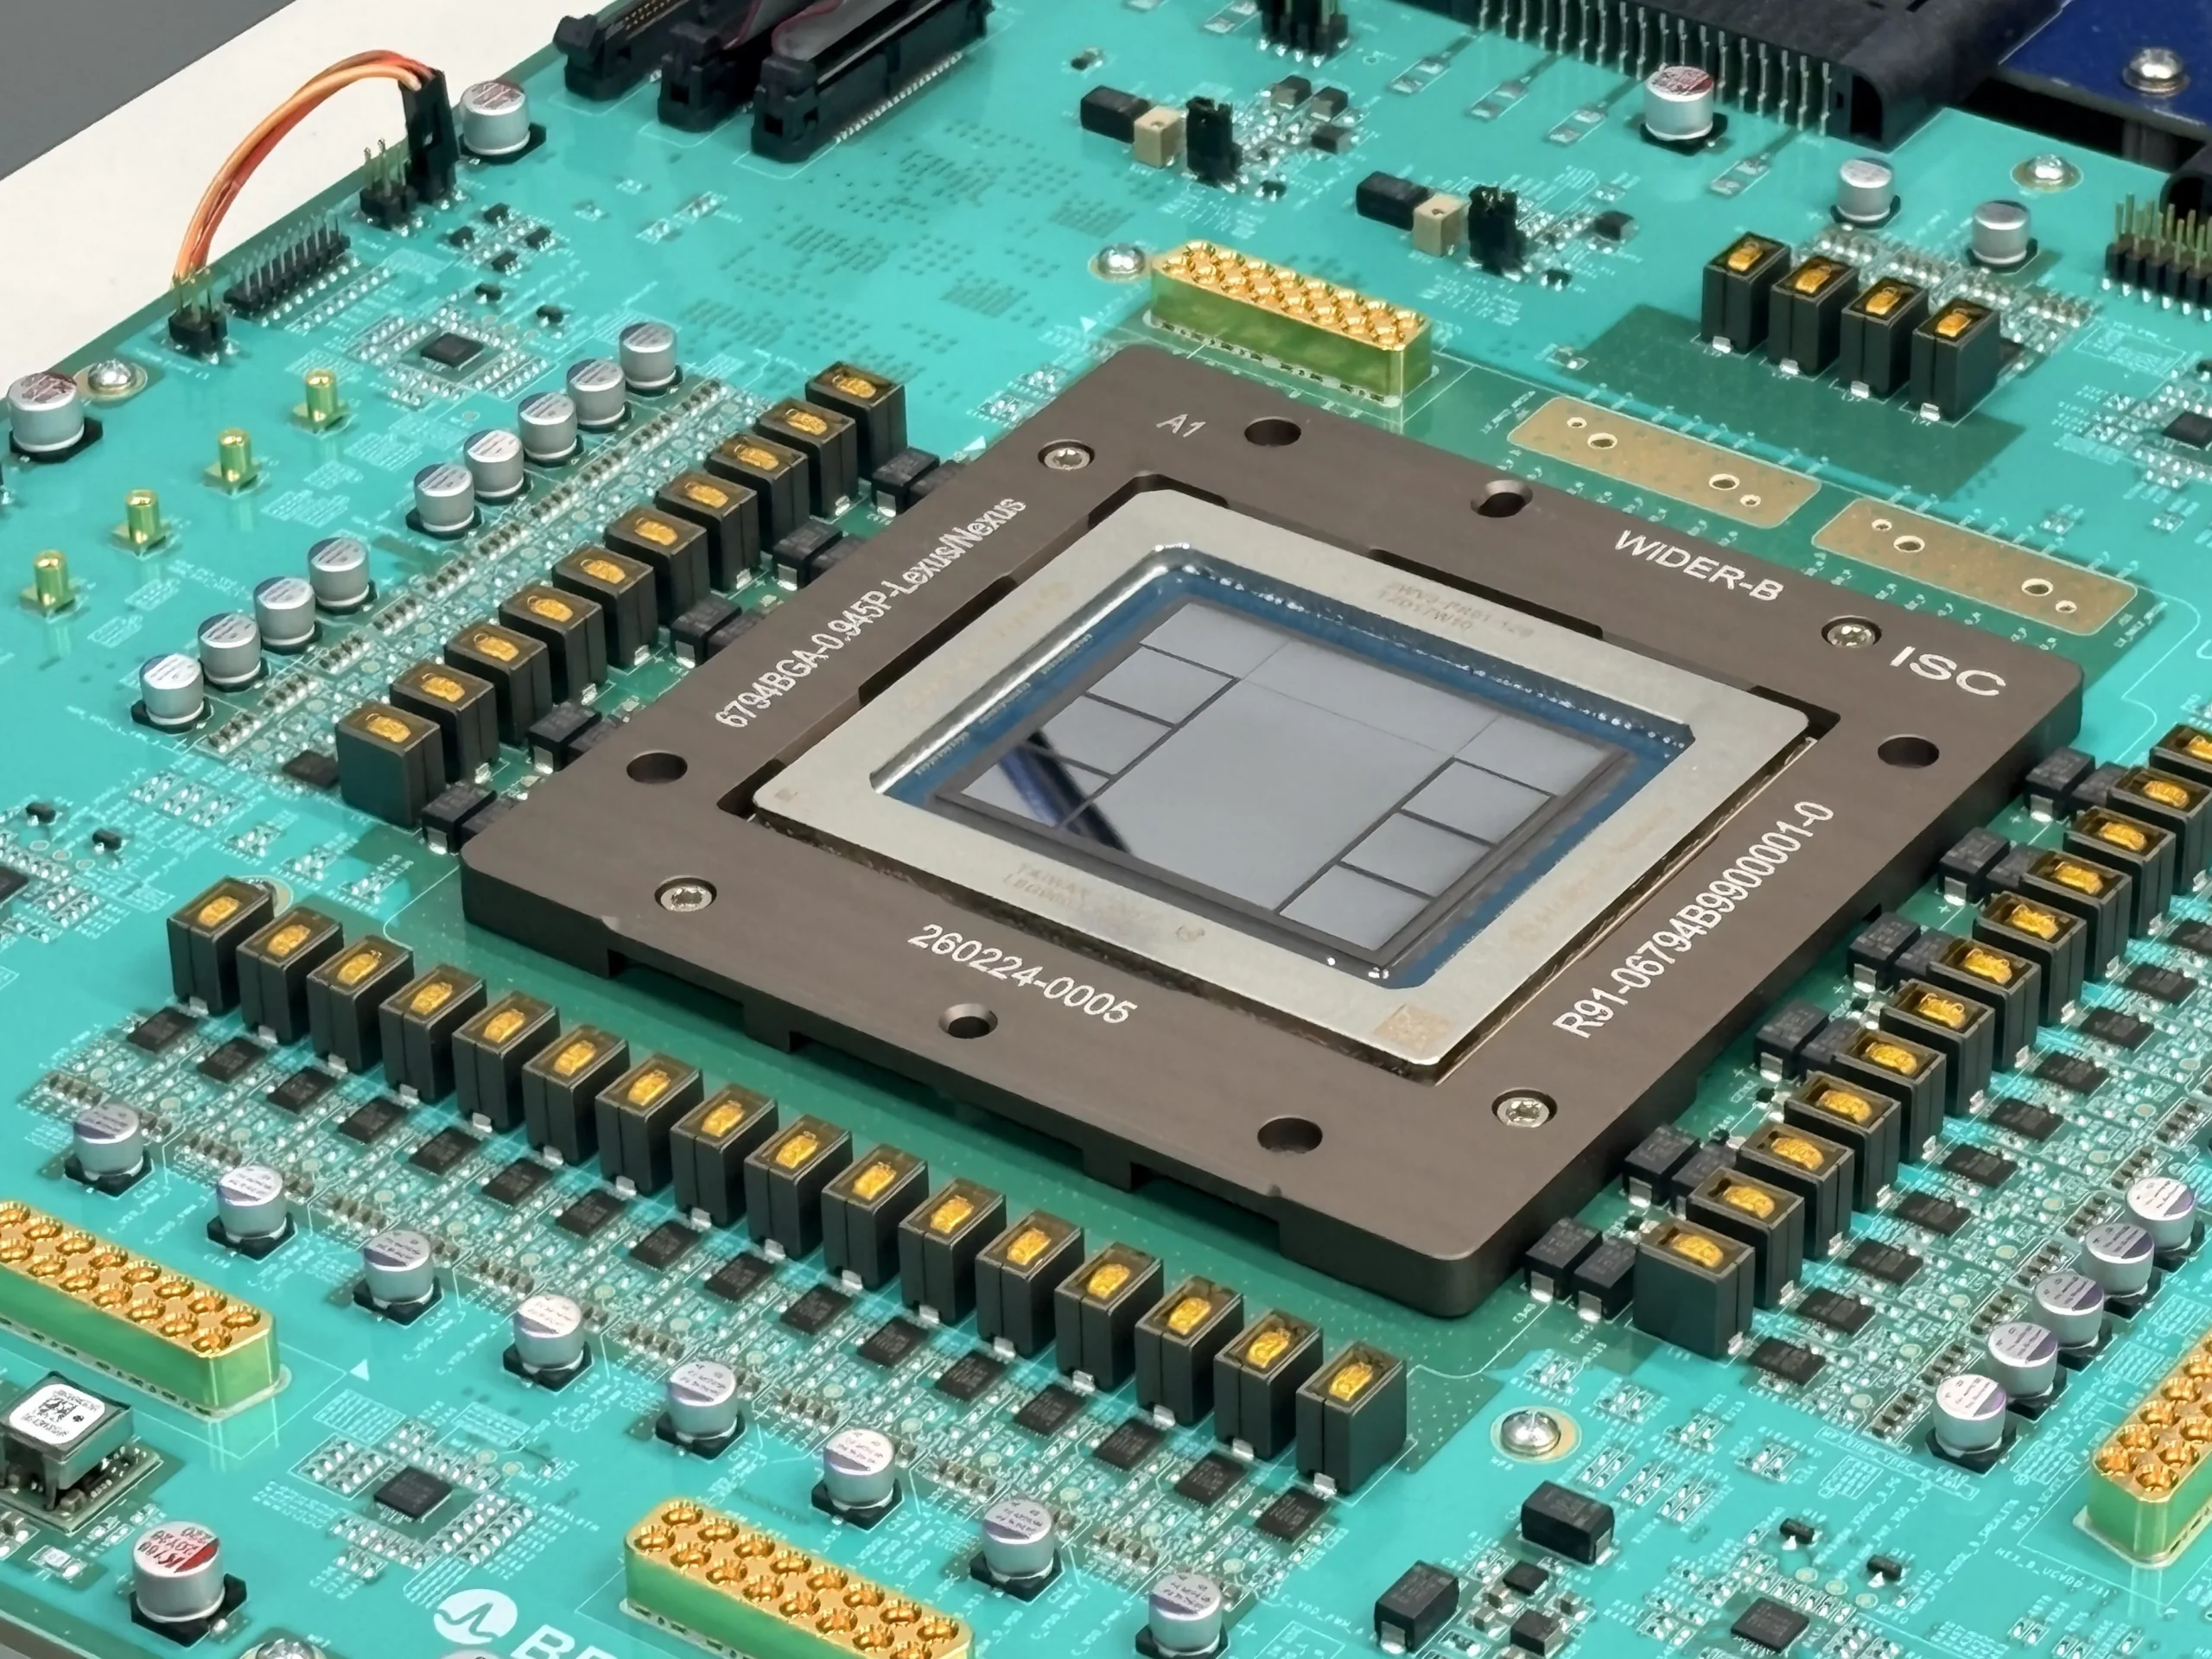
Richard Ho, wiceprezes OpenAI do spraw sprzętu, ujawnił w rozmowie z IEEE Spectrum, że zespół pracujący nad akceleratorem Jalapeño liczył średnio mniej niż 100 osób, a droga od pierwszej koncepcji architektury do pierwszego krzemu zajęła niecałe 20 miesięcy.
- Akcelerator Jalapeño został zaprojektowany przez zespół liczący średnio mniej niż 100 osób, a od pierwszego kodu RTL do tapeoutu minęło zaledwie dziewięć miesięcy – OpenAI przypisuje część tego tempa wewnętrznym modelom językowym dostrojonym specjalnie do projektowania układów scalonych.
- Pojedynczy akcelerator Jalapeño osiąga 13,4 PFLOP/s w formacie MXFP4, dysponuje 216 GiB pamięci HBM4 i mieści się w budżecie 700 W, a według danych producenta oferuje przepustowość na kilowat wyższą o 1,5–1,9 raza i opóźnienia niższe o 1,7–3,6 raza w porównaniu z systemami rackowymi Nvidii GB200 i GB300.
- Gdy pierwsze układy wróciły z fabryki w maju 2026 roku, wewnętrzne modele OpenAI podniosły wydajność jądra multi-head latent attention z modelu DeepSeek z 0,31 proc. do 88,94 proc. teoretycznego pułapu obliczeniowego w około 40 godzin.
Od napisania pierwszego kodu RTL do tapeoutu minęło dziewięć miesięcy, a OpenAI przypisuje część tego tempa własnym modelom językowym, w tym wewnętrznym wersjom dostrojonym specjalnie do projektowania układów scalonych.
Pełne wystąpienie Richarda Ho i Chrisa Leary’ego na konferencji IEEE Hot Chips 2026, na którym padły liczby dotyczące zysków z optymalizacji prowadzonej przez AI, jest dostępne w archiwum konferencji: hc2026.hotchips.org.
Zespół liczył mniej niż 100 osób, a projekt fizyczny przejął Broadcom
Grupa odpowiedzialna za Jalapeño przez cały czas trwania projektu liczyła średnio poniżej 100 osób i mniej więcej tyle samo liczy dzisiaj, gdy pracuje nad drugą i trzecią generacją układu. Ho zaznacza, że w tej liczbie mieszczą się bardzo różne role w zespole sprzętowym, od projektowania systemu po oprogramowanie i łańcuch dostaw, ale nie obejmuje ona ludzi po stronie Broadcomu, który był partnerem projektu.
Podział pracy między obiema firmami przebiegał wzdłuż granicy projekt-wdrożenie. OpenAI odpowiadało za projekt całego systemu: sam akcelerator do inferencji, hierarchię pamięci i sieć. Broadcom przejął, jak to ujął Ho, projekt fizyczny od poziomu bramek logicznych w górę.
„Modele dają naszym inżynierom supermoce” / „The models are giving superpowers to our engineers”, powiedział Ho magazynowi IEEE Spectrum. Dodał od razu zastrzeżenie, które w całej tej historii jest ważniejsze od samego cytatu: to inżynierowie nadal prowadzą pracę i nadal są ostateczną instancją decyzyjną, mogą tylko robić więcej rzeczy szybciej i sprawdzać więcej ścieżek.
RTL, czyli register-transfer level, to poziom opisu układu, na którym inżynier definiuje jego logikę w formie kodu. Tapeout to moment, w którym gotowy projekt trafia do fabryki.
Jalapeño ma 13,4 petaflopsa w MXFP4 i 216 GiB pamięci HBM4 w budżecie 700 W
Specyfikację układu OpenAI ujawniło 25 sierpnia 2026 roku podczas Hot Chips 2026, dwa miesiące po tym, jak 24 czerwca razem z Broadcomem pokazało sam fakt istnienia Jalapeño. Układ jest przeznaczony wyłącznie do inferencji, czyli obsługi zapytań użytkowników, a nie do trenowania modeli.
Parametry pojedynczego akceleratora wyglądają tak:
- 13,4 PFLOP/s w formacie MXFP4, czyli czterobitowym formacie zmiennoprzecinkowym z blokowym skalowaniem,
- 3,4 PFLOP/s w formacie MXFP8,
- 216 GiB pamięci HBM4, co odpowiada mniej więcej 232 gigabajtom w zapisie dziesiętnym,
- 15,4 TB/s przepustowości pamięci,
- 700 W mocy znamionowej na pakiet,
- 64 plastry rdzeni, każdy sparowany z własnym plastrem pamięci w układzie typu NUMA.
Pełny pod złożony z 2048 układów osiąga 27 EFLOPS w MXFP4, 432 TiB pamięci HBM4 i 32 PB/s zagregowanej przepustowości. W pojedynczej szafie pracuje 128 akceleratorów połączonych Ethernetem z prędkością 600 GB/s.
Benchmarki, na które powołuje się OpenAI, mówią o przepustowości na kilowat wyższej o 1,5-1,9 raza oraz opóźnieniach end-to-end niższych o 1,7-3,6 raza w porównaniu z systemami rackowymi Nvidii GB200 i GB300. To dane producenta i nikt ich jeszcze niezależnie nie zweryfikował. Dla porównania GB300 ma 288 GB pamięci HBM3e i moc znamionową 1400 W.
Jalapeño jest produkowany w procesie 3 nm. Pierwsze wdrożenia zaplanowano na koniec 2026 roku, pełna produkcja ma ruszyć w 2027, a prezes Broadcomu Hock Tan zapowiedział produkcję na pełnych obrotach w pierwszej połowie 2028 roku. Układ jest pierwszym elementem platformy, w ramach której OpenAI i Broadcom zapowiedziały w październiku 2025 roku wdrożenie akceleratorów o łącznej mocy 10 GW.
OpenAI oparło front-end na XLS, czyli syntezie przypominającej pisanie oprogramowania
Przepływ pracy po stronie front-endu OpenAI zbudowało wokół XLS (Accelerated Hardware Synthesis), otwartego zestawu narzędzi do syntezy wysokopoziomowej, który powstał pierwotnie w Google. Synteza wysokopoziomowa pozwala projektować układ w środowisku programistycznym bliższym zwykłemu kodowaniu: w XLS można pisać w DSLX, języku dziedzinowym inspirowanym Rustem, albo w C++, a narzędzie tłumaczy to na Verilog, czyli język opisu sprzętu.
To nie był przypadkowy wybór. Chris Leary, member of technical staff w OpenAI, wyjaśnił IEEE Spectrum, że zespół szukał sposobu na przyspieszenie projektu przy pomocy AI, a modele radziły sobie znacznie lepiej z rzeczami, które wyglądają jak oprogramowanie. XLS pod pewnymi względami wygląda właśnie tak. Leary zna te narzędzia od podszewki, bo sam zapoczątkował projekt XLS jeszcze w czasach pracy w Google.
Ankur Srivastava, dyrektor do spraw inicjatyw i innowacji półprzewodnikowych na University of Maryland, tłumaczy, dlaczego to ma sens. Automatyzacja w projektowaniu układów istnieje od dekad i nie jest nowym problemem. Modele językowe różnią się od wcześniejszych narzędzi tym, że rozumieją język i kod, więc nadają się przede wszystkim do tych zadań projektowych, które wciąż pozostają w domenie językowej problemu.
Andrew Kahng, distinguished professor na UC San Diego, ocenia decyzję o wykorzystaniu AI do przyspieszenia syntezy wysokopoziomowej jako naturalną, bo taki materiał jest dla modelu łatwiejszy w obróbce i pozwala na szybkie iteracje. Jego zdaniem ten sposób pracy ma przed sobą przyszłość.
Wydajność jądra obliczeniowego wzrosła z 0,31 do 88,94 proc. teoretycznego pułapu w około 40 godzin
Najmocniejsza liczba w całym materiale IEEE Spectrum nie dotyczy projektowania sprzętu, tylko oprogramowania. Gdy w maju 2026 roku pierwsze układy wróciły z fabryki, OpenAI skierowało swoje wewnętrzne modele na pisanie oprogramowania do testów wydajności, między innymi benchmarku InferenceX firmy SemiAnalysis. Na teście jądra multi-head latent attention z modelu DeepSeek wydajność wzrosła z 0,31 proc. teoretycznego pułapu, wyznaczonego przez moc obliczeniową i przepustowość pamięci, do 88,94 proc. w około 40 godzin.
Ho twierdzi, że ten wynik da się powtórzyć, a to oznacza skrócenie okresu między dostarczeniem pierwszych układów przez fabrykę a rozruchem produkcji. Wszystkie założenia harmonogramowe zespołu mają się od teraz opierać na tym, że taka możliwość istnieje.
Na Hot Chips 2026 Ho i Leary podali też liczbę dotyczącą optymalizacji projektu fizycznego prowadzonej z udziałem AI: 10 proc. redukcji powierzchni jednostek mnożenia macierzy w porównaniu z zoptymalizowanym punktem odniesienia przygotowanym przez ludzi. Innymi słowy OpenAI twierdzi, że upakowało więcej układów logicznych na tej samej powierzchni krzemu, niż było to wcześniej możliwe.
Liczba, która robi na mnie największe wrażenie, to nie 13,4 petaflopsa ani nawet 40 godzin na optymalizację jądra. To jest stu ludzi. Przez dwadzieścia lat obowiązywało założenie, że wejście na rynek zaawansowanych akceleratorów wymaga tysięcy inżynierów i budżetu, który mają trzy firmy na świecie. OpenAI właśnie pokazało, że przy odpowiednim partnerze i odpowiednich narzędziach ten próg jest niżej.
Mam jednak trzy zastrzeżenia. Pierwsze: OpenAI ocenia tu własną pracę własnymi benchmarkami, a niezależnych pomiarów Jalapeño jeszcze nie ma. Drugie: najtrudniejszą część, czyli projekt fizyczny, przejął Broadcom, który skraca harmonogramy również dzięki ponownemu wykorzystaniu własnych bloków logicznych z wcześniejszych projektów. Trzecie, dla mnie najciekawsze: jeśli projektowanie przestaje być wąskim gardłem, to wąskie gardło przesuwa się gdzie indziej, czyli na dostępność HBM4 i moce produkcyjne fabryk. Tych dwóch rzeczy żaden model językowy nie przyspieszy.
Osobne pytanie brzmi, co ta zmiana oznacza dla inżynierów. Ho mówi o supermocach, ale ta sama liczba, sto osób, z drugiej strony wygląda jak informacja o tym, ilu ludzi już nie trzeba.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl

Eksperci uznali harmonogram za wiarygodny, ale przypisują go też Broadcomowi
David Chin, współzałożyciel startupu Verkor.io zajmującego się agentowym projektowaniem układów, ocenia harmonogram podany przez OpenAI jako całkiem wiarygodny, ale uważa pomoc Broadcomu za warunek jego dotrzymania. Jego zdaniem gdyby ktoś inny zaczynał od zera, taki wynik nie byłby możliwy.
Ravi Krishna, również współzałożyciel Verkor.io, nazwał tempo OpenAI stosunkowo imponującym rezultatem i dodał, że gdyby projekt startował dzisiaj, lepsze możliwości modeli pozwoliłyby zejść jeszcze niżej. Kahng poszedł dalej i określił szybkość OpenAI jako prawdopodobnie najlepszą w swojej klasie w tej chwili.
Krishna zwraca przy tym uwagę na moment historyczny. Prace nad Jalapeño ruszyły w październiku 2024 roku, a partnerstwo z Broadcomem ujawniono publicznie dopiero rok później. Jego zdaniem podejście OpenAI do back-endu wygląda już dzisiaj nieco zachowawczo właśnie dlatego, że decyzje zapadały wcześnie. Modele zaczęły sobie naprawdę radzić z tymi zadaniami dopiero od kwietnia 2026 roku. Suresh Krishna, trzeci współzałożyciel Verkor.io, mówi wprost, że nie ma powodu, dla którego agentowa pętla nie miałaby przyspieszyć również back-endu.
Sam Broadcom pracował na własnym przepływie narzędzi. Jego zespół nie miał dostępu do wewnętrznych modeli OpenAI, korzystał wyłącznie z publicznych, komercyjnych wersji.
Projekt zaczynał na modelu o3, a kończył na poprzednikach GPT-6 Astra
Zmiana możliwości modeli w trakcie trwania projektu jest jednym z ciekawszych wątków całej historii. Leary mówi, że na początku zespół wspierał się modelami pokroju o3, udostępnionego publicznie w kwietniu 2025 roku, choć zespół Jalapeño miał go wcześniej. Pod koniec prac inżynierowie korzystali już z poprzedników GPT-6 Astra, czyli modelu, który trafił do publicznego obiegu dopiero 3 września 2026 roku.
Różnica jest konkretna: nowszy model potrafi pracować bezpośrednio w Verilogu, bez pośrednictwa XLS tłumaczącego kod ze zwykłych języków programowania. Według Leary’ego jest też blisko samodzielnej obsługi zamkniętych narzędzi projektowych.
Ho potwierdził, że zespół miał do dyspozycji wewnętrzne modele dostrojone do projektowania układów, niedostępne publicznie, ale odmówił podania szczegółów. Zapowiedział natomiast, że wnioski z projektu mają trafić do komercyjnych modeli OpenAI i że Astra oraz kolejne modele będą bardzo dobre w projektowaniu chipów.
OpenAI zastrzega, że projektowania układów nie da się w pełni zautomatyzować
Ho i Leary postawili wyraźną granicę. Nikt w OpenAI nie twierdzi, że dowolna osoba może zbudować najnowocześniejszy akcelerator AI, używając wyłącznie Codeksa, czyli firmowej platformy do kodowania. Teza OpenAI jest węższa: da się lepiej korzystać z Codeksa i da się małym zespołem w krótkim czasie dojść do dobrego rezultatu.
Leary przyznaje przy tym, że przy Jalapeño zespół wybierał to, co historycznie działa, zamiast eksperymentować, bo liczyło się tempo. Przy drugiej generacji pojawia się okazja do resetu i przemyślenia całego środowiska pracy od nowa. Ho mówi o wprowadzaniu AI w wielu nowych miejscach, przede wszystkim w weryfikacji i projekcie fizycznym. Zespół ma już narzędzia do automatycznej analizy przebiegów sygnałów, które pomagają wskazać sygnały zegarowe powiązane z awariami i poprawić debugowanie sprzętu jeszcze na etapie projektowania.
W oficjalnym komunikacie z czerwca OpenAI ujęło to bardziej marketingowo: „Jalapeño powstał od pierwszego projektu do tapeoutu produkcyjnego w zaledwie dziewięć miesięcy” / „Jalapeño was co-developed from initial design to manufacturing tape-out in just nine months”. Firma nazwała to najszybszym cyklem rozwoju układu ASIC, jaki jej zdaniem kiedykolwiek osiągnięto w zaawansowanych półprzewodnikach o wysokiej wydajności.
Polska postawiła na projektowanie układów w momencie, gdy AI zmniejsza zespoły projektowe
Dla polskiego czytelnika ta historia ma konkretny wymiar, bo projektowanie układów scalonych jest jedną z niewielu specjalizacji półprzewodnikowych, w których Polska realnie istnieje. Ministerstwo Cyfryzacji przygotowało politykę publiczną „Polska w grze o przyszłość, polityka dla sektora półprzewodników 2026+”, która wskazuje projektowanie układów obok fotoniki scalonej i materiałów szerokoprzerwowych jako obszar krajowej przewagi. Dokument przechodzi jeszcze ścieżkę legislacyjną, a termin składania uwag w Komitecie do spraw Cyfryzacji upływał 17 września 2026 roku.
Skala jest na razie niewielka. Z dokumentu wynika, że polski sektor półprzewodników odpowiada dziś za około 0,1-0,15 proc. PKB i opiera się głównie na działalności projektowej, eksporcie komponentów oraz obecności zagranicznych centrów badawczo-rozwojowych. Przy pełnym wykorzystaniu zasobów ma do 2030 roku generować wartość dodaną rzędu 0,4-0,6 proc. PKB. Dla porównania, globalny rynek półprzewodników wart był w 2024 roku około 600 mld euro, a prognozy mówią o bilionie euro w 2030 roku.
„Polska nie zaczyna od zera”, mówił przy prezentacji projektu Dariusz Standerski, wiceminister cyfryzacji, wskazując ośrodki badawcze i firmy rozwijające technologie o znaczeniu strategicznym, w tym właśnie w projektowaniu układów scalonych.
I tu pojawia się napięcie, którego polska strategia nie rozstrzyga. Model rozwoju oparty na budowaniu kadr projektowych dla zagranicznych centrów R&D zakłada, że projektowanie chipów pozostanie pracochłonne. Przypadek Jalapeño jest pierwszym dużym dowodem na to, że niekoniecznie musi. Nie znaczy to, że polskie kompetencje projektowe stracą na wartości, bo Ho podkreśla, że inżynierowie pozostają instancją decyzyjną. Znaczy to raczej, że wartość przesuwa się z liczby inżynierów na to, jak dobrze umieją oni pracować z narzędziami AI. Ta różnica ma bezpośrednie przełożenie na to, czego powinny uczyć polskie uczelnie techniczne i na czym powinny się skupiać programy wsparcia zapisane w polityce sektorowej.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym materiału IEEE Spectrum z dnia 14.09.2026, oficjalnego komunikatu OpenAI z dnia 24.06.2026 oraz relacji Tom’s Hardware z konferencji IEEE Hot Chips 2026. Specyfikację układu zweryfikowano dodatkowo w relacjach ServeTheHome i The Register.
Cytat Richarda Ho, wiceprezesa OpenAI do spraw sprzętu, został zweryfikowany z oryginalnym anglojęzycznym materiałem źródłowym. Wypowiedzi Chrisa Leary’ego, Davida China, Raviego Krishny, Suresha Krishny, Andrew Kahnga i Ankura Srivastavy przytoczono w mowie zależnej na podstawie tego samego materiału.
Polski kontekst opracowano na podstawie projektu polityki publicznej Ministerstwa Cyfryzacji.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji na temat wdrożenia układu Jalapeño i drugiej generacji akceleratorów OpenAI.