AMD przekonuje, że agentowa sztuczna inteligencja przywróci znaczenie komputerom osobistym, bo wysyłanie każdej operacji agenta do chmury szybko staje się zbyt drogie. W demonstracji przygotowanej przez firmę agent obsługujący zgłoszenia klientów przetworzył lokalnie, na komputerze z procesorem Ryzen AI, 69 proc. tokenów, a do modelu w chmurze trafiło tylko 31 proc.
- W demonstracji AMD z konferencji Advancing AI 2026 agent AI obsługujący zgłoszenia klientów przetworzył lokalnie – na komputerze z procesorem Ryzen AI – 69 proc. tokenów, a do modelu w chmurze trafiło tylko 31 proc.
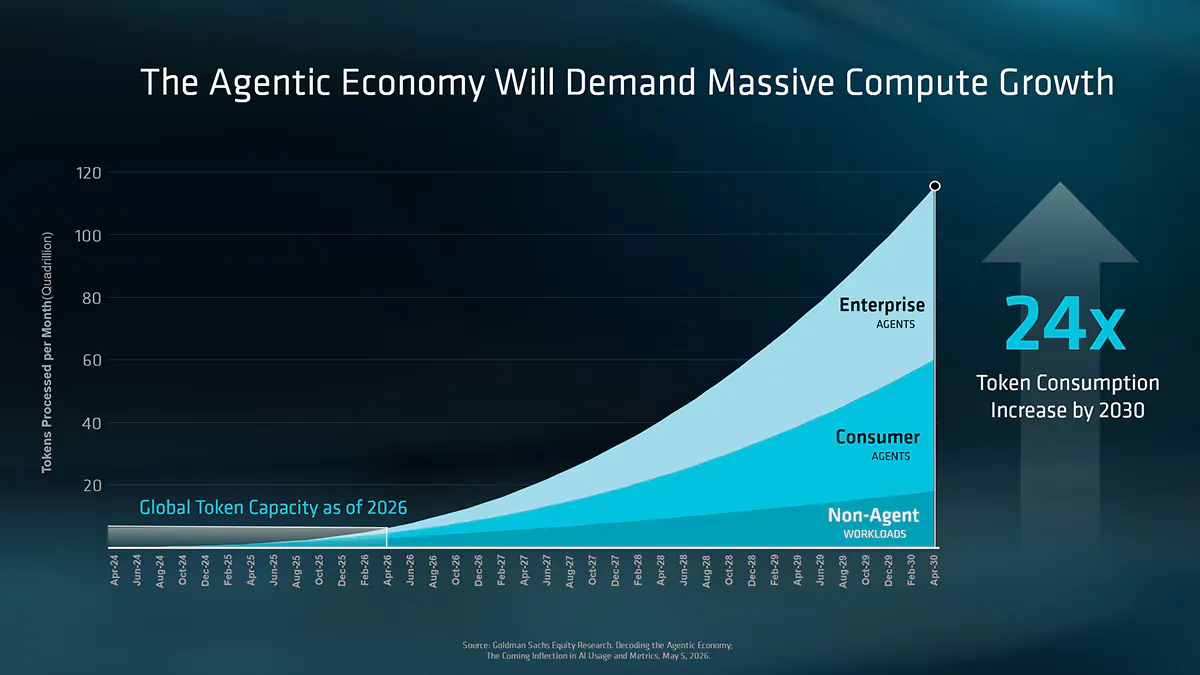
- Według prognozy Goldman Sachs Research z maja 2026 r. agentowa AI zwiększy zużycie tokenów 24-krotnie między 2026 a 2030 rokiem, do 120 biliardów tokenów miesięcznie, przy jednoczesnym spadku kosztu inferencji o 60–70 proc. rocznie.
- Platforma Ryzen AI Max PRO oferuje do 192 GB pamięci zunifikowanej, z czego do 160 GB może obsługiwać GPU, co według AMD pozwala uruchamiać lokalnie modele do 300 mld parametrów – jednak firma nie precyzuje, przy jakiej kwantyzacji wagowej jest to możliwe.
Tezę przedstawił Ian Wineberg, który w AMD zajmuje się segmentem komputerów klienckich i grafiki, we wpisie na firmowym blogu opublikowanym 16 września 2026 r. Wpis podsumowuje pokazy z konferencji Advancing AI 2026, która odbyła się 22-23 lipca w San Francisco. Polskie biuro prasowe AMD rozesłało go do redakcji jako prognozę zmiany trendu, w którym obliczenia od dwóch dekad przenosiły się z biurek do centrów danych.
W pokazie AMD 69 proc. tokenów zostało na komputerze z Ryzen AI
Najbardziej konkretną częścią wpisu jest opis demonstracji z AAI Day, dnia deweloperskiego konferencji. Zgłoszenia od klientów spływały w niej bez przerwy, a agenci AI obsługiwali je na bieżąco: część rozwiązywali automatycznie, resztę eskalowali. Wśród zgłoszeń celowo umieszczono dane wrażliwe, obraźliwe treści i próby ataków typu prompt injection, czyli wstrzykiwania do tekstu ukrytych poleceń dla modelu.
Architektura pokazu składała się z kilku warstw:
- Claude Code od Anthropic pełnił rolę warstwy agentowej: klasyfikował zgłoszenia, analizował, czego wymagają, i wywoływał odpowiednie narzędzia.
- Policy Guard sprawdzał polecenia i wywołania narzędzi względem zdefiniowanych reguł i mógł je blokować albo tylko rejestrować.
- AXIS ograniczał samo wykonanie działań w piaskownicy na poziomie jądra systemu (Landlock, seccomp i przestrzenie nazw sieciowych w Linuksie).
- Lemonade serwował modele lokalnie na komputerze z Ryzen AI i dla każdego zapytania osobno decydował, czy zostaje ono na urządzeniu, czy trafia do modelu w chmurze.
Wineberg opisuje przykład próby dostępu do poświadczeń AWS: Policy Guard mógł ją zatrzymać na wejściu, a jeśli działał tylko w trybie monitorowania, wykonanie blokował AXIS. Rutynowa praca zostawała lokalnie, a zapytania wymagające mocniejszego rozumowania szły do modelu frontier w chmurze. Stąd wynik 69 do 31 proc.
„Pułapka tokenów”: agent zamienia jedno polecenie w łańcuch płatnych zapytań
AMD nazywa problem kosztowy „tokenomics trap”. Chatbot odpowiada na pytanie jednym zapytaniem do modelu, a agent AI wykonujący zadanie wywołuje model wielokrotnie, sięga po narzędzia i dane, sprawdza i poprawia własne wyniki. Wineberg ujmuje to tak:
„Każde zadanie wykonane przez agenta działającego w chmurze zamienia część ludzkiej pracy w tokeny, za które płaci się według zużycia” / „Every task a cloud-based agent executes converts part of a human workflow into metered tokens”
Wpis AMD powołuje się na prognozę Goldman Sachs Research z maja 2026 r. Według banku agentowa AI zwiększy zużycie tokenów 24-krotnie między 2026 a 2030 rokiem, do 120 biliardów tokenów miesięcznie. Autor analizy, Jim Schneider, jednocześnie zakłada, że koszt obliczeń będzie spadał. Według relacji eeNews Europe Goldman Sachs spodziewa się, że producenci półprzewodników będą obniżać koszt inferencji w przeliczeniu na token o 60-70 proc. rocznie.
Tańszy token nie oznacza jednak niższego rachunku, jeśli agent zużywa ich coraz więcej. Wineberg pisze, że w 2026 r. pojawiło się już kilka historii firm, które szeroko wdrożyły agentów w chmurze, a potem wycofywały się, gdy koszty rosły szybciej, niż zakładano. Nie podaje nazw, ale eeNews Europe opisywał w maju dwa takie przypadki:
- Uber analizuje wydatki na AI po doniesieniach, że budżet na AI zaplanowany na 2026 r. wyczerpał się w pierwszych miesiącach roku. Prezes i dyrektor operacyjny Andrew Macdonald mówił, że firma nie widzi jeszcze wyraźnego związku między większym zużyciem tokenów a bardziej użytecznymi funkcjami dla klientów.
- Microsoft według doniesień wygaszał większość wewnętrznych licencji Claude Code w części grupy Experiences + Devices, kierując programistów do GitHub Copilot CLI. Sam GitHub od 1 czerwca 2026 r. rozlicza plany Copilot według zużycia tokenów.
Argument AMD jest spójny, ale trzeba pamiętać, kto go formułuje. To producent procesorów pokazuje demonstrację na własnym sprzęcie, z własnym routingiem, na wybranym przez siebie zadaniu. Wynik 69 proc. dotyczy tokenów, a nie pieniędzy. Do chmury trafiały najtrudniejsze zapytania, obsługiwane przez najdroższe modele, więc realna oszczędność na rachunku może być wyraźnie mniejsza niż sugeruje proporcja. AMD nie podało żadnej kwoty.
Druga rzecz: lokalny agent nie jest darmowy. Komputer ze 192 GB pamięci kosztuje, a pamięć w 2026 r. jest jednym z najdroższych składników sprzętu. Jeśli prognoza Goldman Sachs o spadku kosztu tokena o 60-70 proc. rocznie się sprawdzi, przewaga kosztowa lokalnego przetwarzania będzie się kurczyć. Mocniejszy wydaje mi się argument o danych: zgłoszenie z danymi klienta, które nigdy nie opuszcza firmowego komputera, to realna wartość dla działów prawnych i bezpieczeństwa.
Najciekawsze pytanie zostaje otwarte. Kto będzie zarządzał tysiącami agentów działających na laptopach pracowników, aktualizował ich modele i odpowiadał za ich błędy? Warstwy w rodzaju Policy Guard i AXIS pokazują, że AMD widzi problem, ale od pokazu na scenie do wdrożenia w firmie z dziesięcioma tysiącami stanowisk jest daleko.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl

Ryzen AI Max PRO ze 192 GB pamięci uruchamia modele do 300 mld parametrów
AMD łączy tezę o powrocie PC z dwiema liniami procesorów. Według wpisu Wineberga wyglądają one następująco:
| Platforma | Parametr wskazany przez AMD | Przeznaczenie według AMD |
|---|---|---|
| Ryzen AI PRO 400 | do 60 TOPS wydajności NPU | codzienne zadania AI na komputerach firmowych |
| Ryzen AI Max PRO | do 192 GB pamięci zunifikowanej, z czego do 160 GB może obsługiwać GPU | lokalne modele do 300 mld parametrów i stale działający agenci |
TOPS (bilion operacji na sekundę) to miara wydajności NPU, czyli jednostki przetwarzania neuronowego. Procesory Ryzen AI PRO 400 AMD zaprezentowało na targach CES w styczniu 2026 r. Wineberg zestawia platformę Ryzen AI Max PRO z typowymi laptopami i komputerami stacjonarnymi wyposażonymi w 32-64 GB RAM. AMD nie precyzuje, przy jakiej kwantyzacji (kompresji wag modelu) mieści się model o 300 mld parametrów. Z prostego rachunku wynika, że bez mocnej kompresji do około 4 bitów na parametr nie zmieściłby się w 160 GB.
Po stronie oprogramowania AMD rozwija ROCm.ai, wspólną ścieżkę narzędzi dla procesorów Ryzen, kart Radeon i akceleratorów Instinct. W ramach ROCm.ai firma udostępnia AMD Skills, czyli instrukcje podłączane do asystentów Claude, Codex, Cursor i Gemini, dzięki którym ich podpowiedzi uwzględniają specyfikę sprzętu AMD. Narzędzie ROCm Hyperloom ma samodzielnie wykrywać wąskie gardła w inferencji, wprowadzać poprawki i sprawdzać ich efekt.
AMD nie zapowiada końca chmury, tylko kierowanie zadań tam, gdzie są tańsze
Wpis AMD nie wieszczy odwrotu od centrów danych. Ta sama konferencja Advancing AI 2026 była przede wszystkim premierą Helios, pierwszego systemu AMD w skali całej szafy serwerowej, przeznaczonego do wdrożeń liczonych w gigawatach. Według komunikatu AMD z 23 lipca OpenAI zamierza uruchamiać systemy Helios od czwartego kwartału 2026 r., a Meta testuje je przed wdrożeniem na dużą skalę.
Model, który opisuje Wineberg, to hybryda: decyzja o miejscu wykonania zapada osobno dla każdego zapytania. Lokalne przetwarzanie ma dodatkowe zalety poza kosztem. Dane firmy nie opuszczają urządzenia, zapytanie nie czeka na odpowiedź z serwera, a agent działa także bez połączenia z internetem. Wizję w skali całej organizacji autor opisuje tak:
„Teraz wyobraźcie sobie dziesięć tysięcy takich komputerów w całym przedsiębiorstwie, każdy zaufany i każdy wnoszący wkład w ogólną strategię AI firmy” / „Now picture ten thousand of them across an enterprise, each a trusted machine, each contributing to the overall enterprise AI strategy.”
Ta wizja rozproszonej warstwy obliczeniowej złożonej z komputerów pracowników to na razie kierunek, nie produkt. We wpisie nie ma harmonogramu ani informacji o narzędziach do zarządzania flotą agentów, poza wzmianką, że AMD i Cisco rozmawiali na konferencji o zarządzaniu lokalnymi agentami w firmach.
Polskie firmy też liczą koszty chmury, ale płacą więcej za pamięć
Podobny zwrot widać w polskiej branży IT. Na 9. edycji konferencji AB „Możliwości i Rozwój” 2026, największego wydarzenia dystrybutora AB S.A. dla sektora MŚP, jednym z głównych tematów było przenoszenie części zadań AI z chmury publicznej na własną infrastrukturę i komputery z NPU. Radosław Janka z AB S.A. i Iryna Szwabowska z firmy Safestack argumentowali według relacji ITReseller: „Po jakimś czasie okazało się, że Excel bywa nieubłagany i ekonomia przemawia jednak za rozwiązaniami on-premise, a przynajmniej hybrydowymi”.
Polskie realia mają jednak drugą stronę. Wojciech Zaskórski, dyrektor generalny Lenovo w Polsce, mówił na tej samej konferencji, że przy ograniczonej podaży pamięci i układów producenci komputerów otrzymują często około 40 proc. zamawianego towaru, co prowadzi do wzrostu cen sprzętu. Według prognozy portalu ITHardware udział pamięci w koszcie całego komputera wzrósł w niektórych konfiguracjach do 15-20 proc.
Dla polskiej firmy, która rozważa lokalnych agentów AI, oznacza to prosty rachunek do zrobienia przed zakupem: porównanie miesięcznych kosztów tokenów w chmurze z ceną komputerów z dużą ilością pamięci, rozłożoną na kilka lat użytkowania. Konfiguracje ze 128 czy 192 GB RAM to dziś sprzęt dla zespołów, które naprawdę uruchamiają duże modele lokalnie, a nie standard dla każdego stanowiska.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym wpisu na blogu AMD „Advancing AI 2026: From Gigawatt Data Centers to Agentic PCs” z dnia 16.09.2026, przekazanego redakcji przez AMD CEE PR, oraz komunikatu AMD z konferencji Advancing AI 2026 z dnia 23.07.2026, analizy Goldman Sachs Research i artykułu eeNews Europe. Polski kontekst rynkowy: relacja ITReseller z konferencji AB „Możliwości i Rozwój” 2026 oraz prognoza rynku IT portalu ITHardware.
Cytaty Iana Winberga z AMD zostały zweryfikowane z oryginalnym anglojęzycznym materiałem źródłowym. Wypowiedzi uczestników konferencji AB przytoczono za relacją ITReseller.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji o lokalnych agentach AI i hybrydowych wdrożeniach AMD.