Revolut, największa prywatna firma w Europie, uczynił otwarty model GLM chińskiego laboratorium Z.ai domyślnym narzędziem do pisania kodu dla około 2000 inżynierów i uruchamia go na 56 własnych kartach Nvidia B200. Według Davida Abitbola, który kieruje w Revolucie operacjami AI, koszt spadł do około 30 centów za milion tokenów, co oznacza rachunek dziesięciokrotnie niższy od wcześniejszych faktur od Anthropic i OpenAI.
- Revolut przeniósł około 2000 inżynierów na otwarty model GLM chińskiego laboratorium Z.ai, uruchamiany na 56 własnych kartach Nvidia B200, co obniżyło koszt do około 30 centów za milion tokenów – dziesięciokrotnie mniej niż wcześniejsze rachunki od Anthropic i OpenAI.
- Po wdrożeniu własnego hostingu GLM 5.1 w kwietniu 2026 r. Revolut odnotował poprawę czasu kodowania o około 60 proc. i skrócenie lead time o około 70 proc., podczas gdy wcześniejsze etapy z Google Gemini i Claude Code przyniosły znacznie skromniejsze efekty.
- Dostrojenie serwerów – bez dokupowania dodatkowych kart GPU – skróciło czas do pierwszego tokenu z 14,26 s do 1,68 s i zwiększyło przepustowość z około 3 do ponad 7 zapytań na sekundę na tych samych 56 kartach B200.
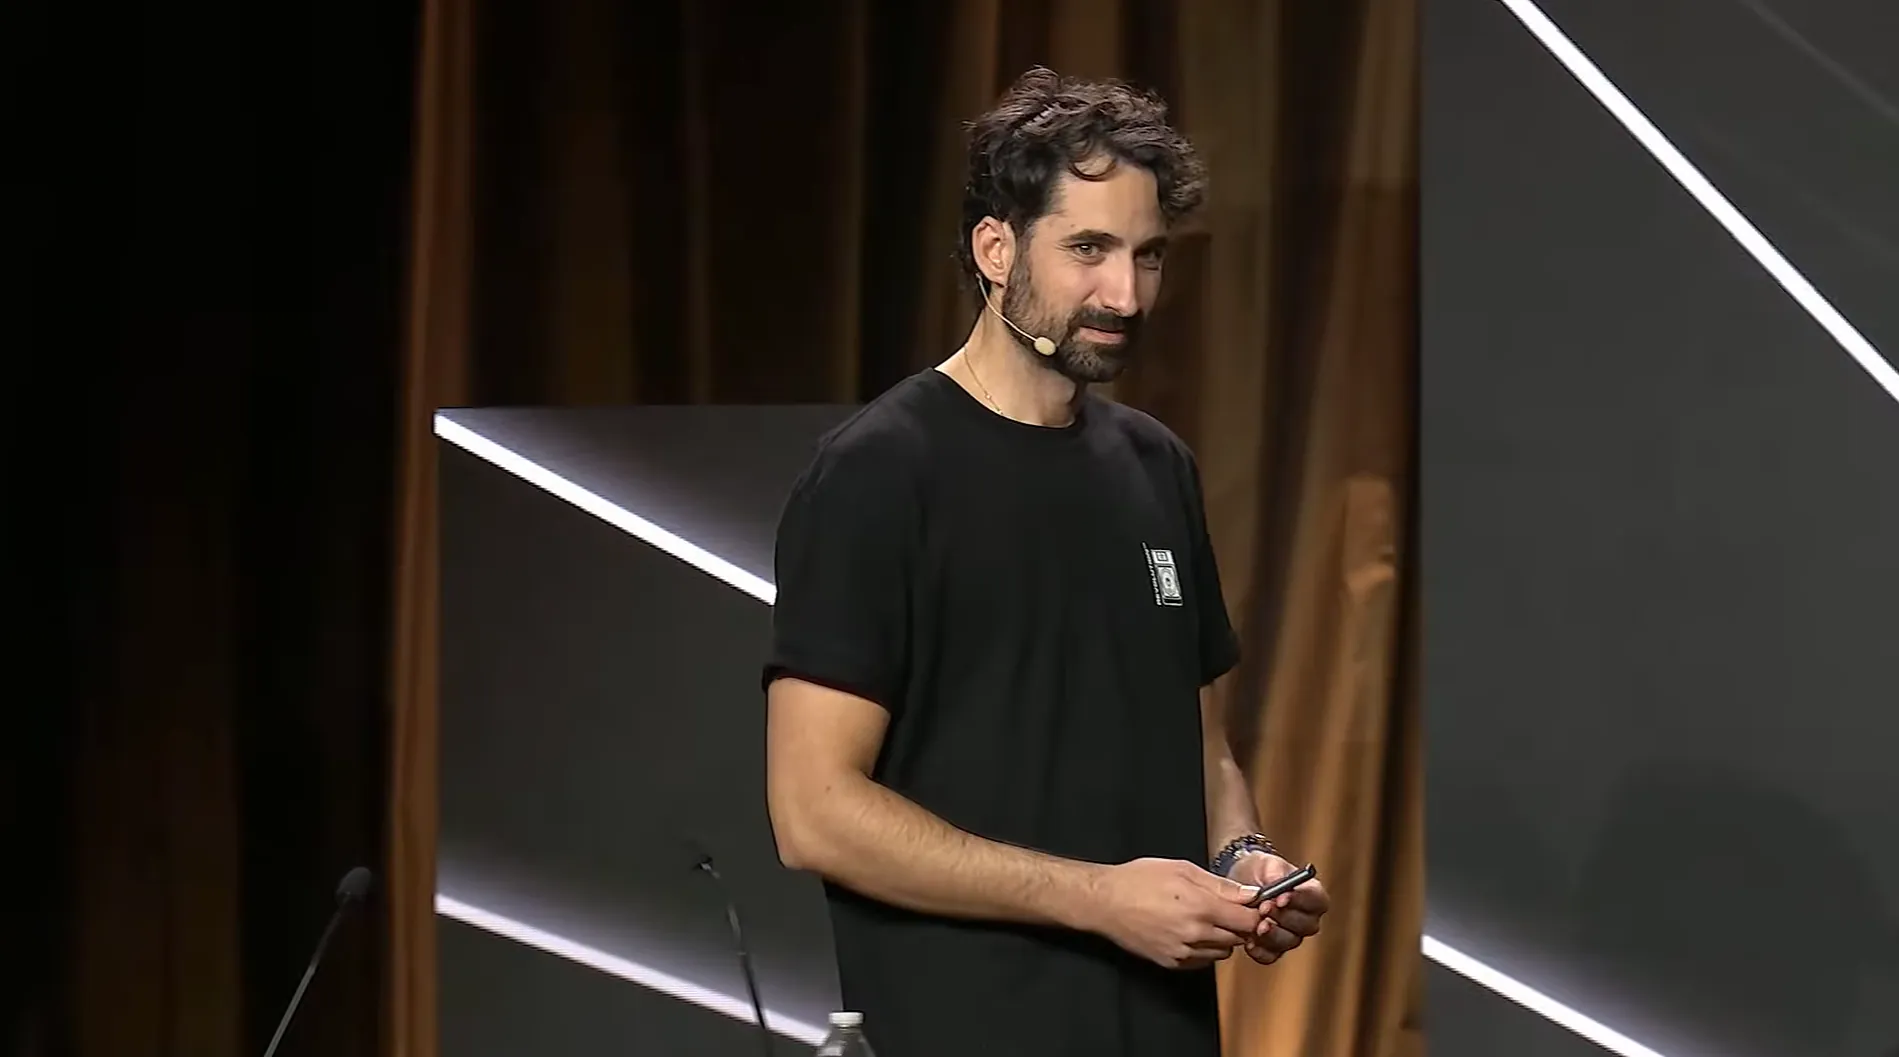
Nagranie wystąpienia: Shipping like a startup, regulated like a bank (AI Engineer NYC 2026)
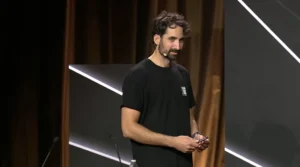
David Abitbol przedstawił dane Revolutu na konferencji AI Engineer w Nowym Jorku
Liczby pochodzą z krótkiego, około 12-minutowego wystąpienia, które Abitbol wygłosił 13 października 2026 r. na głównej scenie konferencji AI Engineer NYC 2026. Organizatorzy przedstawiają go jako lidera operacji i infrastruktury w Revolucie. Sam zaczął od tego, że prowadzi w firmie operacje AI.
Revolut mierzy wpływ AI na pracę inżynierów dwiema metrykami:
- czas kodowania, liczony w godzinach,
- lead time, czyli czas od podjęcia zadania przez inżyniera do scalenia kodu i gotowości do wdrożenia, liczony w dniach.
Dane obejmują próbę około 2000 inżynierów z ostatniego roku. Revolut zaczął hostować GLM 5.1 w kwietniu 2026 r. Obecnie serwuje GLM 5.3. Część mediów, w tym serwis Startup Fortune, napisała o modelu GLM-4.5 i wystąpieniu na GTC w Berlinie. Materiały organizatora konferencji i zapis wystąpienia wskazują jednak na nowsze wersje GLM i nowojorską konferencję AI Engineer.
Najpierw Gemini, potem Claude Code z limitami, na końcu własny GLM
Revolut wprowadzał AI do pracy inżynierów w trzech etapach. Według Abitbola dopiero trzeci przyniósł wyraźny skok.
| Etap | Kiedy | Czas kodowania | Lead time |
|---|---|---|---|
| Google Gemini w całej firmie | styczeń 2025 | poprawa o ok. 20 proc. | poprawa o ok. 10 proc. |
| Claude Code na dużą skalę, ze ścisłymi limitami budżetu | po pierwszych testach w 2025 r. | niewielki efekt | niewielki efekt |
| Własny hosting GLM 5.1 | kwiecień 2026 | poprawa o ok. 60 proc. | poprawa o ok. 70 proc. |
Gemini pomógł głównie w szukaniu informacji i czytaniu dokumentacji. Inżynierowie przestali przekopywać Stack Overflow. Z Claude Code było gorzej pod względem ekonomicznym. Abitbol mówił, że niektórzy inżynierowie wydawali na tokeny od tysiąca do dziesięciu tysięcy miesięcznie bez wyraźnego zwrotu. Dlatego firma wprowadziła sztywne limity budżetu.
Limity wywołały kolejny problem. Inżynierowie oszczędzali tokeny na najtrudniejsze zadania programistyczne albo na koniec kwartału. Po przejściu na własny model rachunek stał się stały i Revolut zniósł ograniczenia.
Abitbol tłumaczy, że lead time poprawił się bardziej niż czas kodowania, bo inżynierowie zaczęli oddawać AI pracę wokół kodu: przeglądanie skrzynki pocztowej, obsługę zgłoszeń w Jirze i szukanie informacji w Confluence.
„Wąskim gardłem w inżynierii niekoniecznie jest samo kodowanie” / „the bottleneck for engineering is not necessarily coding”
Organizatorzy konferencji w opracowaniu wystąpienia zaznaczają uczciwie, że porównanie Revolutu nie oddziela wpływu zmiany modelu od innych czynników, np. zniesienia limitów tokenów.

Strojenie serwerów skróciło czas pierwszej odpowiedzi z ponad 14 do 1,7 sekundy
Sam zakup kart graficznych nie wystarczył. Abitbol przyznał, że po prostym wgraniu wag modelu na GPU wydajność była fatalna. Na slajdzie pokazał, że w okresie migracji czas do pierwszego tokenu wynosił 14,26 s. Po dostrojeniu spadł do 1,68 s. W tym samym czasie liczba zapytań na sekundę wzrosła z około 3 do ponad 7. Wszystko na tych samych 56 kartach B200.
Revolut przyjął kilka konkretnych zasad:
- czas do pierwszego tokenu poniżej 3 sekund (powyżej 5 sekund, jak mówił Abitbol, jego skrzynka na Slacku zaczyna się zapełniać skargami),
- około 200 tokenów na sekundę w pracy interaktywnej, bo inżynierowie coraz częściej uruchamiają zadania równolegle i wracają do nich po zakończeniu,
- okno kontekstu ograniczone do 256 tys. tokenów, choć model obsłużyłby milion (Abitbol nazwał długi kontekst wprost oszustwem),
- kwantyzacja FP4 na kartach z generacji Blackwell, która według niego zmniejsza zapotrzebowanie na pamięć GPU o około 40 proc. względem FP8 bez utraty precyzji w tym zastosowaniu,
- równoległość tensorowa na 8 kartach zamiast 4, żeby zostało miejsce na pamięć podręczną KV,
- odsetek trafień w cache powyżej 90 proc. dla zadań programistycznych.
Po godzinie 17, gdy obciążenie spada, model potrafi generować nawet 800 tokenów na sekundę. Główna rada Abitbola dla innych firm brzmi: zanim dokupisz GPU, dostrój to, co już masz.
Przez ostatnie miesiące obserwuję, jak firmy liczą ROI z narzędzi AI do kodowania i wychodzi im różnie. Revolut pokazuje coś, o czym mało kto mówi. Problemem nie była jakość Claude Code. Problemem był licznik, który sprawiał, że ludzie bali się używać narzędzia do drobnych, nudnych zadań. A właśnie tam leży sporo zmarnowanego czasu.
Mam jednak dwie wątpliwości. Po pierwsze, wynik 60 i 70 proc. to wewnętrzne dane Revolutu, bez niezależnej weryfikacji i bez oddzielenia efektu modelu od efektu zniesienia limitów. Po drugie, oszczędność 90 proc. dotyczy faktury za tokeny. Nie obejmuje zespołu, który miesiącami stroił serwery, ani kosztów monitoringu. Firma z kilkudziesięcioma programistami nie ma takiej skali i pewnie nie powtórzy tego wyniku.
Ciekawsze pytanie dotyczy Anthropic i OpenAI. Jeśli „wystarczająco dobry i tani” model staje się domyślnym narzędziem w regulowanym banku, to co zostaje dla drogich modeli? Na razie zadania wyjątkowe. Czy to wystarczy, żeby utrzymać obecne ceny?
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl
Chiński model na amerykańskich serwerach, z człowiekiem przy każdej operacji
Revolut pobiera tylko otwarte wagi GLM i uruchamia je na infrastrukturze w Stanach Zjednoczonych. Żadne zapytanie nie trafia do usługi Z.ai w Chinach. Abitbol przyznał, że wokół chińskich modeli open source narosło sporo uprzedzeń. Jego zdaniem z punktu widzenia przepływu danych liczy się miejsce uruchomienia modelu, nie kraj jego pochodzenia.
Abitbol mówił, że dane mogą być przetwarzane w krajach objętych ramami równoważności ochrony danych: w USA, UE, Wielkiej Brytanii i Izraelu. Dostawcy GPU, z których korzysta Revolut, domyślnie nie przechowują danych.
Revolut jako bank regulowany w UE podlega jednemu z najostrzejszych reżimów zgodności. Rozwiązaniem okazało się traktowanie agentów kodujących jako narzędzi zwiększających produktywność, zawsze z człowiekiem w pętli:
- piaskownica z regułami określa, które operacje agent wykona sam, a które wymagają zgody (Abitbol podał przykład: grep tak, gradle nie),
- te same reguły chronią przed nadużyciami ze strony nieuczciwych pracowników,
- rozbudowana telemetria w standardzie OpenTelemetry pozwala prześledzić każdy incydent.
GLM jest modelem tekstowym. Zadania z obrazami Revolut kieruje do Gemini. Claude Code i Codex pozostają dostępne jako wyjątek przy najtrudniejszej pracy. Modele są wystawione przez API zgodne z OpenAI, więc inżynierowie korzystają z nich w narzędziach takich jak OpenCode czy Codex.
Oszczędność 90 proc. dotyczy tokenów, nie całego kosztu wdrożenia
Skala Revolutu tłumaczy, dlaczego taki projekt w ogóle się opłacił. Abitbol mówił na scenie o 80 mln klientów w 45 krajach. Według danych przekazanych przez firmę w lipcu przychody Revolutu wzrosły w 2025 r. o 46 proc., do 6 mld dolarów, a zysk przed opodatkowaniem wyniósł 2,3 mld dolarów.
Dealroom, który opisał wystąpienie 3 listopada, zwraca uwagę, że wyliczenie 90 proc. nie obejmuje kosztów chmury, personelu ani monitoringu. Organizatorzy AI Engineer dodają, że koszt 30 centów za milion tokenów opisuje konkretne wdrożenie i wykorzystanie sprzętu Revolutu. To nie jest cena, którą da się przenieść na dowolną firmę hostującą otwarty model.
Revolut zatrudnia w Polsce ponad 1300 osób i szuka kolejnych inżynierów
Polska jest czwartym największym rynkiem Revolutu i największym w Europie Środkowo-Wschodniej. W lipcu 2026 r. firma podawała, że ma u nas ponad 5,5 mln klientów. Zapowiedziała też zatrudnienie ponad 300 osób w ciągu roku, m.in. w inżynierii i analityce danych, co ma zwiększyć polski zespół z ponad 1300 do ponad 1600 osób. Część stanowisk jest w Warszawie i Krakowie, część zdalnie.
Abitbol nie podał, ilu z około 2000 inżynierów z próby pracuje w Polsce. Revolut nazywa jednak Polskę jednym ze swoich największych zaplecz kadrowych, więc nowy sposób pracy z AI zapewne dotyczy też polskich programistów.
Dla polskich firm, zwłaszcza z sektora finansowego, przypadek Revolutu jest praktyczną wskazówką. Moim zdaniem pytanie „czy wolno używać chińskiego modelu” jest źle postawione. Lepiej zapytać, gdzie fizycznie działa model, kto ma dostęp do danych i jakie operacje agent może wykonać bez człowieka. Każda firma musi jednak odpowiedzieć na nie z własnym działem zgodności. Sami organizatorzy konferencji zastrzegają, że uwagi Abitbola o regulacjach opisują sytuację Revolutu i nie są ogólną wykładnią przepisów.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym opracowania i zapisu wystąpienia Shipping like a startup, regulated like a bank na stronie AI Engineer NYC 2026 z dnia 13.10.2026 oraz Dealroom, StartupHub.ai. Wykorzystano także materiały Startup Fortune, Trending Topics i GIGAZINE. Dane o działalności Revolutu w Polsce: Brandsit.
Cytat Davida Abitbola, lidera operacji i infrastruktury AI w Revolucie, został zweryfikowany z oryginalnym anglojęzycznym materiałem źródłowym.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji o wykorzystaniu otwartych modeli AI przez Revolut i inne banki.