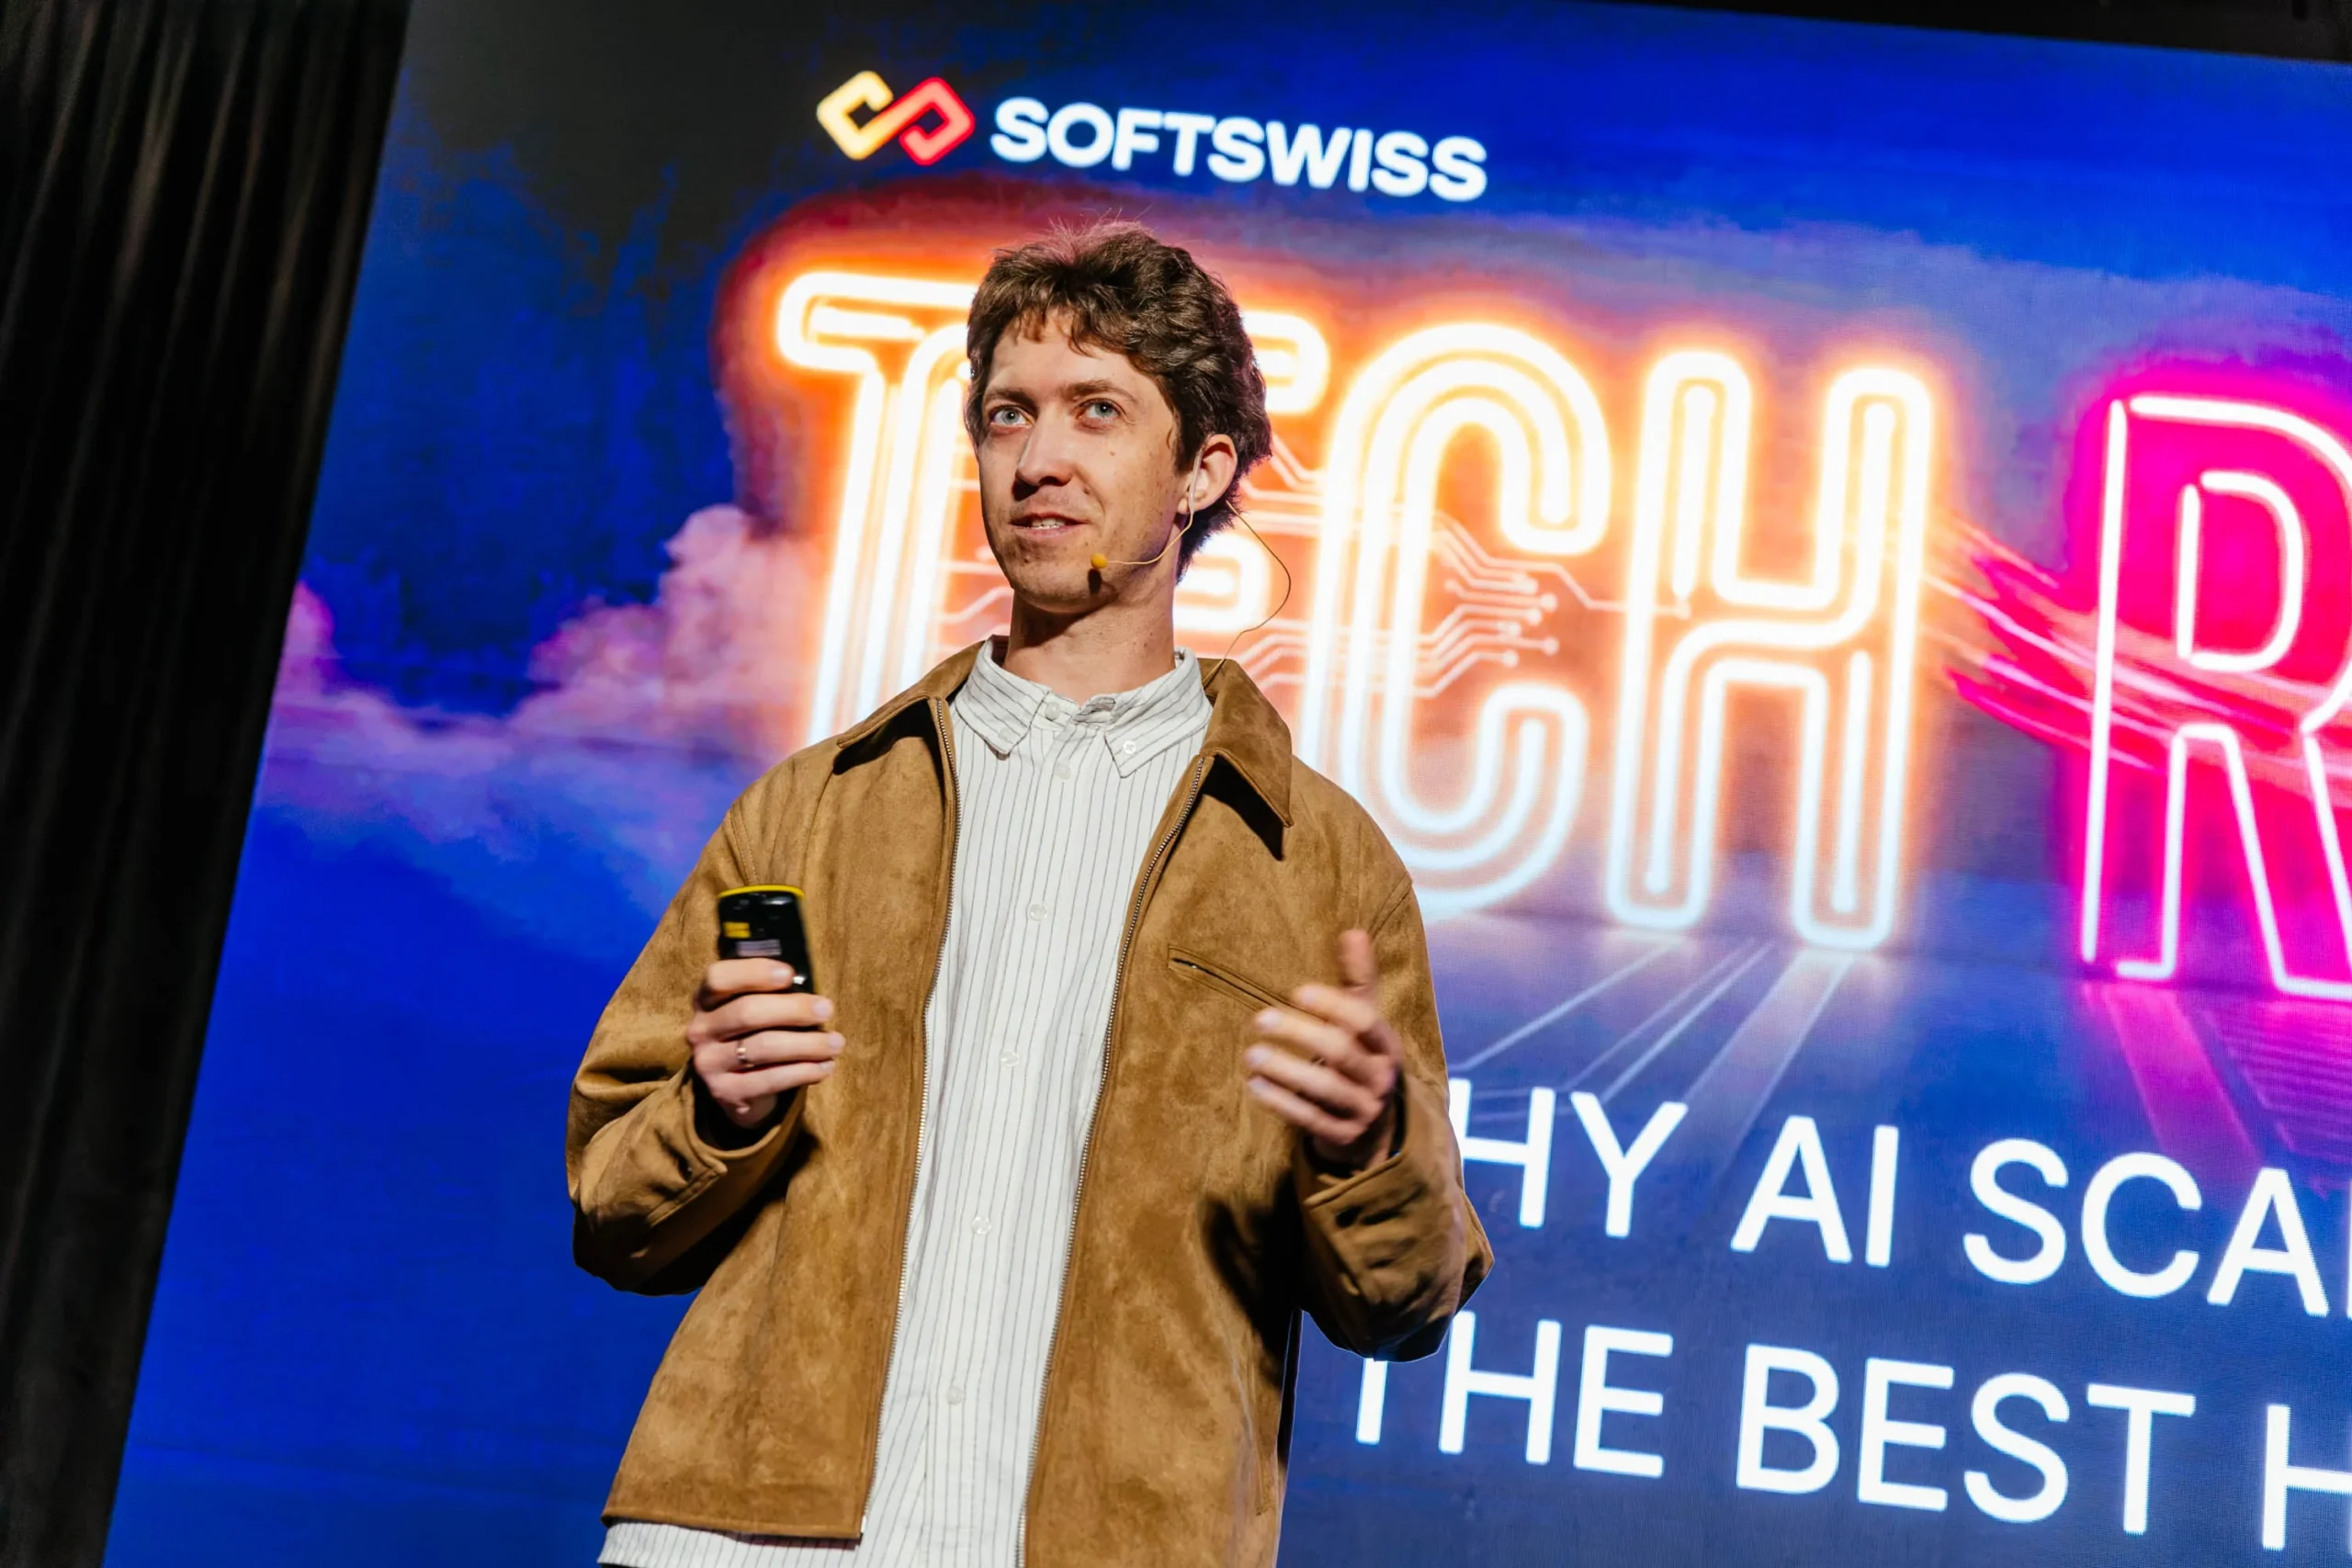
10 września 2026 r. w Centrum Praskim Koneser w Warszawie odbyła się pierwsza edycja Tech Race Summit, konferencji firmy SOFTSWISS o systemach pracujących pod dużym obciążeniem, z wystąpieniami m.in. AWS, Oracle, Google Cloud, Cloudflare i Gcore. Kordian, Dyrektor IT AIPORT.pl zaproszony na wydarzenie, śledził transmisję z trzech równoległych scen i wrócił z jednym głównym wnioskiem: w rozmowach o sztucznej inteligencji sam model zszedł na drugi plan, a na pierwszy wysunęły się infrastruktura, bezpieczeństwo, obserwowalność i koszty.
- Tech Race Summit 2026 odbył się 10 września 2026 r. w Centrum Praskim Koneser w Warszawie – to pierwsza edycja konferencji organizowanej przez SOFTSWISS, z udziałem ponad 30 prelegentów z firm takich jak AWS, Oracle, Google Cloud, Cloudflare i Gcore oraz około 1000 uczestników stacjonarnych.
- Gartner prognozował w czerwcu 2025 r., że do końca 2027 r. przerwanych zostanie ponad 40 proc. projektów z agentami AI z powodu rosnących kosztów, niejasnej wartości biznesowej lub słabej kontroli ryzyka.
- Według GUS w 2025 r. technologie AI stosowało zaledwie 8,7 proc. polskich przedsiębiorstw (wobec 5,9 proc. rok wcześniej), a wśród dużych firm odsetek ten wyniósł 42 proc., wśród średnich 15,6 proc., a wśród małych 6,1 proc.
Konferencję oglądałem online. Wybrałem ją ze względu na tematy, z którymi mam do czynienia przy budowie systemów internetowych: duży ruch, chmurę, skalowanie infrastruktury i cyberbezpieczeństwo. Coraz częściej dochodzi do tego AI uruchamiane w środowisku produkcyjnym, a nie w wersji demonstracyjnej.
I było co oglądać.
SOFTSWISS zebrał w Koneserze ponad 30 prelegentów na trzech scenach
Tech Race Summit 2026 to nowa konferencja organizowana przez SOFTSWISS, firmę dostarczającą od 2009 r. oprogramowanie dla branży iGaming, czyli gier i zakładów online. Organizator zapowiadał ponad 30 międzynarodowych prelegentów, około 1000 uczestników i trzy równoległe sceny, a wszystkie wystąpienia prowadzono po angielsku.
Program podzielono na trzy ścieżki:
- Vision Track, poświęconą strategii, transformacji biznesu i przywództwu technologicznemu,
- Solution Track, z tematami architektury, chmury, wydajności i platform dla zespołów inżynierskich,
- Experiment Track, z bardziej eksperymentalnymi podejściami, od metryk pracy inżynierów po autonomicznych agentów do obsługi incydentów.
Sergey Kastukevich, CTO SOFTSWISS, tłumaczył w majowej zapowiedzi, że szefowie technologii chcieli miejsca na prawdziwe rozmowy o architekturze i szczere analizy awarii, a takiego wydarzenia brakowało.
„Takiego miejsca nie było, więc je stworzyliśmy” / „That space didn’t exist, so we built it.”
Poniżej wystąpienia, do których odnoszę się w tej relacji:
| Firma | Prelegent | Wystąpienie | Scena |
|---|---|---|---|
| AWS | Sergey Kurson, Viktor Vedmich | AI Maturity: AWS Roadmap for Strategic AI Adoption | Vision Track |
| Oracle | Georgios Chatzimilioudis | Building AI Infrastructure and Platforms for the Future: Oracle’s perspective | Vision Track |
| Cloudflare | Michael Tremante | The Future Of Work: How LLMs Are Changing The Office Work Floor | Vision Track |
| Oracle | Harsh Jain | Building the AI-Native Enterprise: Engineering Workflows & Platforms | Solution Track |
| Gcore | Vasil Mikhalenya | Five Problems Every iGaming Operator Hits – And the Edge That Solves Them | Solution Track |
| Cloudflare | Tiago Sá | Securing the AI Era: From Workforce Protection to Agentic Control | Solution Track |
| Google Cloud | Dmitry Volokh | Your Engineering Metrics Are Lying | Experiment Track |
Model AI to tylko jeden z wielu elementów systemu produkcyjnego
Najmocniejszy wniosek, jaki wyniosłem z Tech Race Summit, jest taki, że rozmowa o sztucznej inteligencji wyszła poza wybór modelu. Jeszcze niedawno wdrożenie AI sprowadzało się do pytań o liczbę parametrów, jakość odpowiedzi i przygotowanie proof of concept (PoC), czyli wersji próbnej.
Na konferencji to podejście było już wyraźnie przestarzałe. Jeśli system AI ma obsługiwać prawdziwy ruch, model jest tylko jedną z części. Wokół niego trzeba zbudować warstwę odpowiedzialną za:
- kierowanie zapytań do właściwych modeli i usług (routing),
- bezpieczeństwo, uwierzytelnianie i autoryzację,
- dostęp do danych,
- obserwowalność, czyli możliwość prześledzenia, co system robi,
- limity zużycia zasobów i kontrolę kosztów,
- skalowanie,
- obsługę błędów i ścieżki zapasowe,
- audyt działań,
- zarządzanie agentami AI.
W systemach z dużym ruchem szybko okazuje się, że wąskim gardłem wcale nie musi być wydajność modelu. Problemem bywa liczba równoległych zapytań, kolejki, limity zewnętrznych API, baza danych, opóźnienia sieci albo koszt pojedynczej operacji pomnożony przez miliony wywołań.
AWS: o dojrzałości w AI świadczą wdrożenia, a nie liczba prototypów
Sergey Kurson i Viktor Vedmich z AWS przekonywali na scenie Vision Track, że liczba prototypów AI nie mówi nic o dojrzałości organizacji. Firma może mieć kilkadziesiąt PoC, ale jeśli żadnego nie da się bezpiecznie i powtarzalnie przenieść na produkcję, wciąż jest na początku drogi.
W dojrzałym środowisku trzeba odpowiedzieć na pytania mniej efektowne niż wybór modelu:
- kto odpowiada za system podczas awarii,
- jak wygląda monitoring i jakie są SLO (Service Level Objectives, czyli docelowe poziomy jakości usługi),
- co się stanie po przekroczeniu budżetu,
- jak ograniczyć agentowi dostęp do narzędzi,
- co zrobić, gdy model zacznie zwracać błędne odpowiedzi,
- czy da się odtworzyć przebieg operacji wykonanej przez agenta,
- jak wygląda wycofanie zmiany albo przejście na rozwiązanie zapasowe.
Przy tych pytaniach AI zaczyna przypominać każdy inny poważny system produkcyjny. Mocno wybrzmiał też wątek agentowej AI i komunikacji między agentami. Im większa autonomia, tym wyraźniej trzeba określić granice działania agenta: maksymalną liczbę kroków, czas wykonania, koszt i zestaw dostępnych narzędzi. Autonomia bez ograniczeń w systemie produkcyjnym bardzo szybko robi się problemem.
Ostrzeżenie z AWS pokrywa się z danymi analityków. Gartner prognozował w czerwcu 2025 r., że do końca 2027 r. przerwanych zostanie ponad 40 proc. projektów z agentami AI, z powodu rosnących kosztów, niejasnej wartości biznesowej lub słabej kontroli ryzyka. W styczniowym sondażu Gartnera, w którym wzięło udział 3412 uczestników webinaru, 19 proc. zadeklarowało znaczące inwestycje w agentową AI, 42 proc. ostrożne, a 31 proc. czekało na rozwój sytuacji albo nie znało odpowiedzi.
Oracle traktuje AI jako osobny rodzaj obciążenia infrastruktury
Oracle, reprezentowany na scenach przez Georgiosa Chatzimilioudisa i Harsha Jaina, pokazał AI nie jako kolejną funkcję aplikacji, ale jako odrębną klasę obciążenia dla infrastruktury. Uważam, że to trafne podejście.
Architektura aplikacji z AI powinna pozwalać niezależnie skalować model, dane, warstwę orkestracji, integracje, zabezpieczenia i pozostałe komponenty aplikacji. Budowanie jednego monolitu, w którym zmiana modelu albo dostawcy AI wymusza przebudowę całości, to prosta droga do kłopotów. Im większy system, tym ważniejszy jest podział odpowiedzialności.
W systemach z dużym ruchem decyzje o miejscu przechowywania danych, kosztach transferu, izolacji klientów i skalowaniu trzeba podejmować już na etapie projektu. Poprawianie ich po osiągnięciu dużej skali zwykle kosztuje znacznie więcej.
Cloudflare: duże modele językowe stają się usługą całej firmy
Michael Tremante, Field CTO w Cloudflare, mówił o tym, jak duże modele językowe (LLM) zmieniają codzienną pracę biurową. LLM przestają być narzędziem wyłącznie programistów i działów badawczo-rozwojowych, bo korzystają z nich pracownicy niemal wszystkich działów.
Z tego wynika praktyczne pytanie: jak dać ludziom dostęp do AI i jednocześnie zachować kontrolę nad danymi oraz uprawnieniami? W dużej organizacji trudno zaakceptować sytuację, w której każdy pracownik sam wybiera przypadkowe narzędzie i wkleja do niego firmowe dane.
Model językowy staje się więc wspólną, centralnie zarządzaną usługą organizacji, z określonym uwierzytelnianiem, dostępem do danych, kontrolą kontekstu i politykami bezpieczeństwa. Branża przerabiała już podobne problemy przy chmurze, aplikacjach SaaS i architekturze Zero Trust, w której żadne połączenie nie jest z góry uznawane za zaufane.
Cieszy mnie, że na warszawskiej scenie rozmowa o AI przesunęła się z pytania „który model wybrać?” na pytanie „kto za to odpowiada, kiedy coś pójdzie źle?”. To dojrzalsze i uczciwsze podejście niż kolejne efektowne dema. Patrzę jednak na tę konferencję z pewnym dystansem. Zorganizował ją dostawca oprogramowania dla branży iGaming, a wśród partnerów są firmy, które sprzedają dokładnie te warstwy, o których mówiono ze sceny: ochronę na brzegu sieci, obserwowalność i chmurę. Teza „filtruj ruch, zanim dotrze do serwerów aplikacji” jest słuszna z inżynierskiego punktu widzenia, ale jest też częścią oferty handlowej Cloudflare i Gcore. Nie odbiera to wartości tym wystąpieniom. Przypomina tylko, że architekturę dobiera się do własnej skali, a nie do skali prelegenta. Zadaję sobie też pytanie, ilu polskich firm te problemy dotyczą już dziś. Skoro zdecydowana większość przedsiębiorstw w Polsce w ogóle nie korzysta z AI, najcenniejsza lekcja z Konesera brzmi dla nich tak: limity, uprawnienia i koszty trzeba zaplanować przed uruchomieniem pierwszego agenta, a nie po pierwszym incydencie.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl
Gcore pokazał pięć problemów, które zna każdy serwis z dużym ruchem
Vasil Mikhalenya z Gcore przygotował jedno z najbardziej praktycznych wystąpień dnia. Na przykładzie platform iGamingowych omówił pięć klas problemów, które dotyczą właściwie każdego systemu z dużym ruchem:
- nagłe skoki ruchu,
- przejmowanie kont użytkowników,
- ataki DDoS w warstwie aplikacji (L7),
- opóźnienia przy globalnym zasięgu,
- nadużycia ze strony botów.
Podoba mi się to podejście, bo zamiast haseł dostajemy konkretne kategorie problemów.
Przy skokach ruchu średnie obciążenie mówi niewiele. Serwis może przez większość dnia wykorzystywać 20 proc. zasobów, a w ciągu kilkunastu sekund dostać kilkukrotnie większy ruch. Planowanie pojemności musi więc uwzględniać nagłe piki, a nie tylko średnią dobową.
Atak DDoS w warstwie aplikacji ma dodatkową pułapkę. Jeśli system odpowiada na niego dokładaniem kolejnych instancji serwerów, to własną infrastrukturą i własnym budżetem obsługuje ruch napastnika. Filtrowanie powinno odbywać się jak najwcześniej, najlepiej na brzegu sieci (edge), zanim zapytanie dotrze do kosztownej części systemu.
Opóźnienia przy globalnym zasięgu nie znikają po wyborze „dobrego regionu” chmury. Znaczenie mają punkty obecności sieci (PoP), peering, trasa pakietów i ostatni odcinek do użytkownika. Kilkadziesiąt dodatkowych milisekund na kilku etapach składa się na opóźnienie, które użytkownik wyraźnie odczuwa.

Automatyczne skalowanie bez limitów może zamienić awarię w ogromny rachunek
Wystąpienia na scenie Solution Track przypomniały, że produkcja nie przebiega według optymistycznego scenariusza. Projektując nowy system, łatwo skupić się na ścieżce, w której wszystko działa: użytkownik wysyła zapytanie, serwer je odbiera, model odpowiada, odpowiedź wraca.
W rzeczywistości model może przekroczyć limit czasu, zewnętrzny dostawca może zacząć zwracać błędy, może skończyć się przydział zapytań, baza może odpowiadać pięć razy wolniej, ruch może wzrosnąć dziesięciokrotnie, a agent może uruchomić sekwencję działań, której nikt nie przewidział. System pod dużym obciążeniem projektuje się więc najpierw pod scenariusze awarii, a dopiero potem pod ścieżkę optymistyczną.
Automatyczne skalowanie w chmurze jest świetnym mechanizmem, ale nie rozwiązuje wszystkiego. Jeśli system dokłada instancje przy każdym wzroście ruchu, zamiast awarii można dostać gigantyczny rachunek. Dlatego obok skalowania potrzebne są kolejki, limity równoległości, priorytety, ograniczanie liczby zapytań (rate limiting), mechanizm backpressure, czyli sygnalizowanie nadawcy, że system nie nadąża, oraz celowe odrzucanie nadmiarowego ruchu (load shedding).
System powinien umieć powiedzieć: „w tej chwili więcej ruchu nie przyjmę”. Kontrolowane odrzucenie części zapytań bywa zdrowsze niż próba obsłużenia wszystkiego za wszelką cenę.
Kolejnym powracającym motywem był platform engineering, czyli budowanie wewnętrznej platformy dla zespołów programistów. Zespół produktowy nie powinien sam od zera projektować monitoringu, wdrożeń, zarządzania sekretami, dostępu do modeli, polityk bezpieczeństwa, logowania, śledzenia zapytań i kontroli kosztów. Organizacja powinna dać mu gotową, sprawdzoną ścieżkę (tzw. golden path), dzięki której nową usługę uruchamia się szybko i bez rozwiązywania tych samych problemów po raz kolejny. Przy kilkudziesięciu czy kilkuset zespołach różnica jest ogromna.
Google Cloud: więcej kodu napisanego z AI nie oznacza większej produktywności
Dmitry Volokh, Engineering Manager w Google Cloud, wystąpił na scenie Experiment Track z prezentacją o metrykach pracy zespołów, które piszą kod z pomocą AI. Tytuł mówił wprost, że te metryki kłamią.
AI potrafi mocno przyspieszyć pisanie kodu, ale więcej kodu nie oznacza większej produktywności. Jeśli programista z pomocą AI wprowadza dwa razy więcej zmian, a jednocześnie rośnie liczba poprawek, błędów, wycofanych wdrożeń i czas przeglądu kodu, trudno mówić o dwukrotnym wzroście wydajności.
Dlatego obok klasycznych wskaźników DORA (zestawu metryk opisujących sprawność dostarczania oprogramowania) coraz większą wagę mają:
- ilość pracy do poprawienia,
- obciążenie osób przeglądających kod,
- odsetek zmian kończących się awarią,
- incydenty wywołane kodem wygenerowanym przez AI,
- niezawodność,
- koszt.
Najbardziej zainteresował mnie pomysł mierzenia kosztu udanego zadania zamiast kosztu pojedynczego zapytania. Z biznesowego punktu widzenia zapytanie za pół centa, które nie rozwiązało problemu użytkownika, wcale nie było tanie.
Agent AI potrzebuje własnych uprawnień i pełnego śledzenia działań
Bezpieczeństwo AI zajmowało w programie dużo miejsca. Tiago Sá z Cloudflare mówił o zabezpieczaniu firm w epoce AI, od ochrony pracowników po kontrolę agentów, Alexandra Pryadko, również z Cloudflare, o wdrażaniu publicznie dostępnej AI bez wizerunkowych wpadek, a na scenie Vision Track odbył się panel o ryzykach cyberbezpieczeństwa związanych z AI.
Z tych rozmów wynika wyraźna zmiana w myśleniu o uprawnieniach. Do tej pory pytaliśmy głównie, co może zrobić użytkownik. W systemach agentowych trzeba też zapytać, co może zrobić agent działający w jego imieniu.
Moim zdaniem agent powinien dostawać minimalny zestaw uprawnień potrzebny do konkretnego zadania. Jeśli ma tylko odczytać dane, nie powinien móc ich zmieniać. Jeśli ma wykonać jedną operację, nie potrzebuje dostępu administratora do całego systemu.
Do tego dochodzi prompt injection, czyli atak polegający na przemyceniu do modelu złośliwych poleceń. To już nie jest wyłącznie problem dziwnych odpowiedzi. Jeśli agent korzysta z zewnętrznych narzędzi i pobiera dane, spreparowane polecenie może doprowadzić do operacji, której system nie powinien wykonać. Uważam, że granice autonomii, kontrola ruchu wychodzącego, krótko ważne dane uwierzytelniające i zasada najmniejszych uprawnień staną się stałym elementem architektury AI.
Agenci komplikują też obserwowalność. W klasycznej aplikacji śledzenie rozproszone (distributed tracing) pozwala prześledzić zapytanie przechodzące między mikroserwisami. W systemie z agentami droga zapytania może wyglądać tak: użytkownik, API, agent, model, narzędzie, baza danych, kolejny model, następne narzędzie i dopiero odpowiedź. Jeden ślad powinien łączyć zapytanie użytkownika, decyzje agenta, wywołania modeli i narzędzi, dostęp do danych, opóźnienia, koszt i końcowy wynik. Bez tego szukanie błędów w złożonych procesach agentowych zamienia się w zgadywanie. Temat obserwowalności kodu pisanego z pomocą AI miał zresztą w programie osobne wystąpienie Lewisa Isaaca z Coralogix.
Polskie firmy dopiero zaczynają etap, o którym mówiono w Koneserze
Tech Race Summit mówił o problemach firm, które mają już AI na produkcji, a w Polsce takich przedsiębiorstw wciąż jest niewiele. Według GUS w 2025 r. technologie AI stosowało 8,7 proc. przedsiębiorstw, wobec 5,9 proc. rok wcześniej, a 91,3 proc. firm z AI nie korzystało wcale. Wśród dużych firm odsetek sięgnął 42 proc. (33 proc. w 2024 r.), wśród średnich 15,6 proc., a wśród małych 6,1 proc. Badanie GUS nie obejmuje mikroprzedsiębiorstw.
Polski Instytut Ekonomiczny zwracał uwagę, że w zależności od metody badania z AI korzysta w Polsce od około 6 do 16 proc. firm. Niezależnie od wyliczeń, większość polskich przedsiębiorstw stoi przed pierwszym wdrożeniem. Dla nich lekcje z Warszawy mają wartość planistyczną: limity kosztów, uprawnienia agentów i śledzenie działań da się zaprojektować od razu, zamiast dobudowywać je po problemach.
Polskie nazwiska pojawiły się też w programie. Prof. Szymon Wąsik, dyrektor ds. inżynierii R&D i AI w ScyllaDB, wygłosił wykład „Not a Model Problem – A Storage Problem” o tym, że ograniczeniem systemów AI często jest przechowywanie danych, a nie model. W panelu o ryzykach AI wzięła udział Alicja Grochocka-Dorocińska ze stowarzyszenia ML in PL i Warszawskiej Wyższej Szkoły Informatyki.
Pięć zasad, które zabieram z Tech Race Summit do własnych projektów
Po obejrzeniu wystąpień spisałem zasady, które da się od razu zastosować przy projektowaniu systemów:
- Najpierw brzeg sieci. Ruch z internetu powinien być w jak największym stopniu weryfikowany i obsługiwany, zanim dotrze do serwera źródłowego. Ograniczanie liczby zapytań, WAF (zapora aplikacji webowych), ochrona przed DDoS, zarządzanie botami i pamięć podręczna działają skuteczniej przed backendem niż za nim.
- Kontrola przepływu zamiast dokładania serwerów. Nie każde zapytanie trzeba obsłużyć natychmiast, a kolejki i limity równoległości często sprawdzają się lepiej niż nieograniczone skalowanie.
- Zaprojektowana degradacja. System powinien wiedzieć, co zrobić, gdy podstawowa ścieżka przestanie działać: użyć mniejszego modelu, przejść w tryb tylko do odczytu, skorzystać z pamięci podręcznej, wyłączyć część funkcji albo skierować operację do ręcznej akceptacji. Dojrzały system nie ma tylko dwóch stanów: „wszystko działa” i „nic nie działa”.
- Percentyle p95 i p99 zamiast średniej. Średnie opóźnienie może wyglądać świetnie, podczas gdy co dwudziesty czy co setny użytkownik regularnie czeka kilka sekund. Przy dużym ruchu ogon rozkładu mówi więcej niż średnia.
- Koszt jako metryka techniczna. Szczególnie przy AI. System może być szybki, stabilny i poprawny, ale jeśli pojedyncza operacja jest zbyt droga przy dużej skali, architektura i tak jest zła.
Transmisja online dała dużo wiedzy, choć bez rozmów w kuluarach
Oglądając Tech Race Summit online, nie mogę ocenić networkingu ani atmosfery na miejscu. Według serwisu dev.by wszystkie około 1000 miejsc stacjonarnych rozeszło się jeszcze w sierpniu, a dostęp do transmisji kosztował 39 euro.
Z perspektywy ekranu całość wypadła bardzo dobrze. Prelegenci byli konkretni i przygotowani, a poziom techniczny wystąpień był różny, ale program trzymał się spójnego tematu. Doceniam, że wiele prezentacji nie ograniczało się do promocji usług chmurowych. Wnioski architektoniczne da się zastosować niezależnie od tego, czy korzysta się z AWS, Google Cloud, Oracle Cloud czy z własnej infrastruktury. Formuła trzech scen pozwalała spojrzeć na podobne problemy od strony strategii, infrastruktury i eksperymentów.
Traci się możliwość rozmowy z prelegentami, ale zyskuje pełne skupienie na treści. Pod tym względem konferencja dała mi bardzo dużo materiału.
Gdybym miał opisać Tech Race Summit 2026 jednym zdaniem, powiedziałbym, że branża przechodzi od zachwytu nad możliwościami AI do inżynierii produkcyjnej. Efektowne demo już nie wystarcza. System musi działać pod obciążeniem, być obserwowalny i bezpieczny, mieć limity, umieć się degradować i pilnować kosztów. A przy autonomicznych agentach trzeba jeszcze dokładnie wiedzieć, co wolno im zrobić i dlaczego wykonali daną operację. AWS, Oracle, Google Cloud, Cloudflare i Gcore patrzyły na ten problem z różnych stron, ale wszystkie te perspektywy prowadziły w tym samym kierunku. Organizator zapowiada kolejną edycję w Warszawie na wrzesień 2027 r.
Źródła i metodologia
Relacja powstała na podstawie transmisji online Tech Race Summit 2026, którą śledził Kordian, Dyrektor IT AIPORT.pl, oraz analizy redakcji AIPORT.pl. Program, tytuły wystąpień i nazwiska prelegentów pochodzą z oficjalnej strony Tech Race Summit. Kontekst rynkowy oparliśmy na komunikacie Gartnera z dnia 25.06.2025 oraz na danych GUS przytoczonych przez PAP Biznes. Wykorzystaliśmy też zapowiedź SOFTSWISS rozesłaną przez PR Newswire 05.05.2026 (next.io), analizę Polskiego Instytutu Ekonomicznego i informacje serwisu dev.by.
Cytat Sergeya Kastukevicha, CTO SOFTSWISS, został zweryfikowany z oryginalnym anglojęzycznym komunikatem prasowym.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji o Tech Race Summit i kolejnej edycji konferencji.