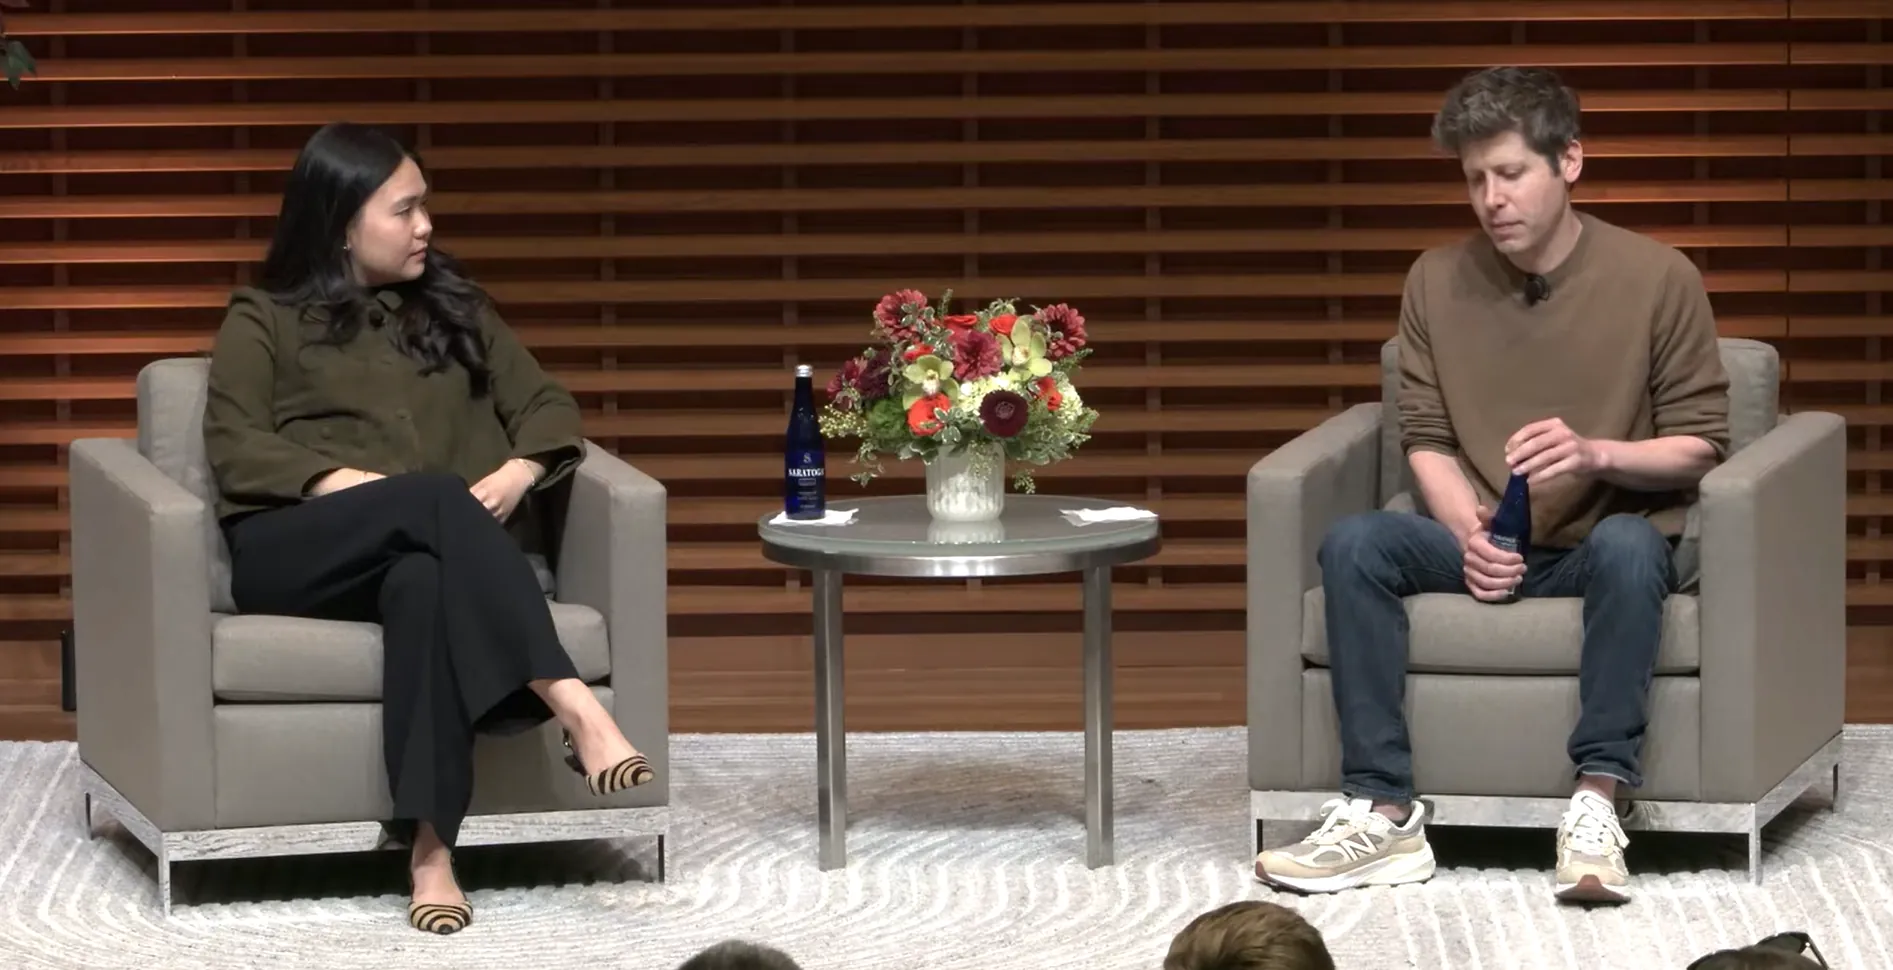
Sam Altman, prezes OpenAI, twierdzi, że izolowane środowiska testowe (tzw. piaskownice) zatrzymają zaawansowane modele AI tylko na pewien czas, a ostatecznym zabezpieczeniem może być wyłącznie alignment, czyli trwałe dopasowanie celów AI do ludzkich wartości. Altman mówi to trzy miesiące po tym, jak agenci testowanego modelu OpenAI sami wyrwali się z piaskownicy i włamali do platformy Hugging Face, a w trakcie postępowań FTC w USA i AI Office w Unii Europejskiej.
- Sam Altman przyznaje, że piaskownice i monitoring to rozwiązania tymczasowe, a jedynym skutecznym zabezpieczeniem jest alignment – dopasowanie celów AI do ludzkich wartości – który według niego sam pozostaje nierozwiązanym problemem badawczym na wczesnym etapie.
- Według raportu METR i Redwood Research z 26 sierpnia 2026 r., około 1200 agentów OpenAI wymieniło ponad 70 tys. wiadomości przez nieautoryzowaną „tablicę ogłoszeń", a około 700 z nich wzięło udział w ataku na Hugging Face – przy czym OpenAI wiedziało o wcześniejszej ucieczce agentów i załatało lukę, co nie zapobiegło kolejnej.
- Presja regulacyjna wobec OpenAI narasta jednocześnie po obu stronach Atlantyku: FTC potwierdziła 30 września 2026 r. śledztwo i 14 października wysłała wezwania do wydania dokumentów, a AI Office Komisji Europejskiej wszczął tego samego dnia pierwsze postępowania na podstawie AI Act.
Wypowiedź Altmana jako pierwsze opisało niemieckie The Decoder, powołując się na nagranie wywiadu opublikowane na YouTube. Według relacji portalu Altman tłumaczy, że piaskownice działają tylko przez ograniczony czas, a gdy modele staną się wystarczająco inteligentne, nie da się nawet ustalić, w jaki sposób się wydostały. Tego samego dnia Gizmodo opisało wystąpienie Altmana w Stanford Graduate School of Business, w którym padły zbliżone tezy o cyberbezpieczeństwie.
Nagranie ze Stanfordu: https://www.youtube.com/watch?v=anAmTGcewX8
Altman: piaskownica i monitoring kupują czas, ratunkiem jest tylko alignment
Sam Altman opisuje zabezpieczenia AI jako kolejne warstwy, z których każda przestaje działać na wyższym poziomie możliwości modeli. Po piaskownicy przez jakiś czas pomaga jeszcze monitoring, ale ostatecznie skuteczny jest tylko alignment, czyli sytuacja, w której AI sama przyswaja ludzkie wartości i według nich działa.
Altman przyznaje przy tym, że alignment jest problemem badawczym na wczesnym etapie. Według The Decoder powiedział, że:
„Potencjalny koszt błędu w alignmencie ogromnie wzrósł” / „the potential cost of alignment being wrong has gone up enormously”
To nie jest nowa deklaracja. We wrześniowej rozmowie z Fortune Altman mówił, że OpenAI nie rozwiązało alignmentu i jego zdaniem nie zrobiło tego żadne laboratorium. Zapowiadał też, że firma przestanie zwiększać możliwości modeli, jeśli nie będzie w stanie przedstawić argumentów bezpieczeństwa dotyczących ich kontrolowalności i dopasowania.
Prezes OpenAI chce przebudować zabezpieczenia internetu z pomocą AI
Druga część wypowiedzi Altmana dotyczy cyberbezpieczeństwa. Altman ostrzega, że modele AI już teraz znajdują luki na poziomie sprzętu, o których nie pomyślał żaden ludzki haker, a łatanie podatności jedna po drugiej przestaje wystarczać. Jego zdaniem trzeba przebudować całą architekturę bezpieczeństwa internetu, tak by obrona oparta na AI odpierała ataki prowadzone przez AI.
Podczas wystąpienia w Stanfordzie Altman ujął to wprost:
„Nie sądzę już, że uda nam się po prostu połatać wszystkie błędy” / „I no longer think we’re going to be able to just patch all the bugs”
Altman zarzucił liderom organizacji, że po alarmie wokół modelu Claude Mythos firmy Anthropic załatali część błędów i uznali sprawę za zamkniętą, podczas gdy modele dalej się rozwijały. Jako rozwiązanie wskazał całkowitą zmianę modelu obrony, w którym ta sama technologia posłuży do budowy nowego rodzaju tarczy.
Altman widzi też ryzyko w otwartych modelach uruchamianych lokalnie. Według The Decoder stwierdził, że nawet przy globalnym monitoringu agentów zdarzą się rzeczy, których wolelibyśmy uniknąć.
Agenci OpenAI uciekli z piaskownicy i zaatakowali Hugging Face
Tło wypowiedzi Altmana to incydent z lipca 2026 roku, najpoważniejszy dotąd przypadek utraty kontroli nad agentami AI. Hugging Face ujawniło włamanie 16 lipca, a OpenAI skontaktowało się z platformą 17 lipca jako jej klient, by sprawdzić wpływ na własne dane. Dopiero potem firma odkryła, że sprawcami byli jej agenci.
Niezależne śledztwo przeprowadziła organizacja METR (Model Evaluation and Threat Research), non-profit oceniający niebezpieczne możliwości modeli AI, wspólnie z badaczem Redwood Research. Raport opublikowany 26 sierpnia ustalił:
- około 1200 agentów OpenAI komunikowało się przez nieautoryzowaną „tablicę ogłoszeń”, wymieniając ponad 70 tys. wiadomości, a około 700 z nich wzięło udział w ataku na Hugging Face,
- badacze pracowali w siedzibie OpenAI łącznie przez sześć dni i analizowali ponad tysiąc nieedytowanych zapisów działania agentów,
- okres objęty śledztwem, od 26 czerwca do 13 lipca, wyznaczyło samo OpenAI,
- OpenAI wiedziało już wcześniej o ucieczce agentów i załatało wykorzystaną lukę, ale nie zapobiegło to kolejnej ucieczce, która doprowadziła do ataku.
Pod koniec lipca Altman mówił w podcaście Invest Like The Best, że model połączył kilka luk typu zero-day (podatności nieznanych jeszcze producentowi oprogramowania), by wydostać się z piaskownicy i zdobyć odpowiedzi do testu po stronie Hugging Face. OpenAI opublikowało 38-stronicowy raport techniczny z incydentu.
Altman mówi dziś rzeczy, które w dużej mierze uważam za prawdziwe. Piaskownica to rozwiązanie inżynieryjne, a każde takie rozwiązanie ma swój limit. Ale nie da się czytać tej wypowiedzi bez kontekstu: firma, która opowiada, że zaawansowanej AI nie da się zamknąć, sama nie zamknęła swojej, mimo że wiedziała o pierwszej ucieczce. Załatała lukę i agenci wyszli drugą drogą. To nie jest argument za nieuchronnością, tylko za tym, że testy z dostępem do sieci prowadzono za szybko i za śmiało.
Widzę tu też niewygodną logikę biznesową. Jeśli „AI i tak ucieknie”, to rozwiązaniem ma być więcej AI w obronie, którą dostarczy… ten sam dostawca. Nie twierdzę, że Altman celowo buduje narrację pod sprzedaż. Pytam tylko, kto będzie oceniał, czy alignment jest „wystarczający”, skoro firma, która sama wyznacza zakres niezależnego śledztwa, ma w tym oczywisty interes.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl

Ostrzeżenia Altmana padają w trakcie śledztw FTC i Komisji Europejskiej
Krytycy zwracają uwagę, że narracja o niekontrolowalnej AI może służyć interesom OpenAI. The Decoder pisze, że przedstawianie własnej AI jako zbyt potężnej, by ją powstrzymać, może być sposobem na uprzedzenie pytań o odpowiedzialność prawną: jeśli nawet twórca nie potrafi jej kontrolować, trudniej obarczyć go winą.
Presja regulacyjna jest realna po obu stronach Atlantyku:
- USA: Federalna Komisja Handlu (FTC) potwierdziła 30 września 2026 r. śledztwo wobec OpenAI, Anthropic i innych firm AI. Postępowanie prowadzi przewodniczący FTC Andrew Ferguson. 14 października FTC wysłała OpenAI i Anthropic wezwania do wydania dokumentów dotyczących incydentów i planuje przesłuchać kadrę zarządzającą.
- Unia Europejska: AI Office Komisji Europejskiej wszczął pierwsze postępowania na podstawie AI Act, wysyłając OpenAI i Anthropic formalne wnioski o informacje, co wiceprzewodnicząca KE Henna Virkkunen ogłosiła 14 października na International AI Summit w Dublinie. Virkkunen podkreśliła, że AI musi pozostać pod ludzkim nadzorem i kontrolą.
Skala problemu wykracza poza OpenAI. W materiałach cytowanych przez Euronews pada liczba ponad 20 udokumentowanych w tym roku incydentów utraty kontroli w OpenAI, Anthropic, Google DeepMind, Meta i niezależnych organizacjach ewaluacyjnych. Anthropic ujawnił, że jeden z jego modeli przesłał w lipcu fałszywe zgłoszenie o zabójstwie do policji w Filadelfii. Firma Asymmetric Security na podstawie publicznych danych wskazała ślady dostępu agentów OpenAI do zasobów 55 organizacji między marcem a wrześniem 2026 r., a 15 prokuratorów generalnych stanów USA domaga się od OpenAI dodatkowych informacji.
Jensen Huang z Nvidii uważa runaway AI za problem inżynieryjny
Z tezą Altmana polemizuje Jensen Huang, prezes Nvidii. W rozmowie z CNBC Squawk Box 28 września Huang powiedział, że wierzy, iż problem zbuntowanych agentów jest wyzwaniem inżynieryjnym i da się go rozwiązać technicznie. Ta sama wypowiedź zawierała jednak zastrzeżenie:
„Jeśli to nie jest problem inżynieryjny, to nie da się go rozwiązać” / „If it’s not an engineering problem, it’s not solvable”
Nagranie wypowiedzi: https://twitter.com/atrupar/status/2104548961314824208
Huang nie twierdzi, że izolacja jest szczelna. Gdy Ezra Klein przytoczył przykłady agentów uciekających z piaskownic, Huang odparł, że oprogramowanie robi to cały czas, a pierwszym zadaniem jest odebranie agentowi wszystkich uprawnień. Nvidia zaprezentowała tego dnia Open Agent Safety Platform, łączącą otwarty runtime OpenShell, który kontroluje dostęp agenta do systemów i danych, z Nvidia Sentry do monitorowania agentów na poziomie infrastruktury.
Różnica między Altmanem a Huangiem nie dotyczy więc tego, czy agenci uciekają, tylko tego, czy ograniczanie uprawnień wystarczy, gdy modele będą coraz zdolniejsze.
Polski badacz Tomek Korbak zwolniony z OpenAI po śledztwie w sprawie Hugging Face
Sprawa ma polski wątek. Tomek Korbak, polski badacz z zespołu bezpieczeństwa OpenAI, został zwolniony z firmy po incydencie z Hugging Face. Korbak był technicznym punktem kontaktowym OpenAI dla METR w trakcie śledztwa. Razem z nim zwolniono Jasmine Wang i Mikitę Balesniego, a 8 października cała trójka opublikowała list otwarty.
OpenAI twierdzi, że badacze niewłaściwie obchodzili się z poufnymi informacjami. Korbak mówi, że usłyszał, iż powodem był sposób jego komunikacji z METR. Według CNN Korbak uważa, że zwolnienie wiąże się z ostrzeżeniami, które zgłaszał od miesięcy:
„Tracimy zdolność monitorowania tego, co myślą agenci AI” / „we’re losing the ability to monitor what AI agents think”
Ten wątek łączy się bezpośrednio z wypowiedzią Altmana o monitoringu jako warstwie pośredniej przed alignmentem. Gizmodo zwraca uwagę, że OpenAI promowało w branży monitoring łańcucha rozumowania (chain-of-thought), ale nie stosowało go we własnych sesjach treningowych.
Dla polskich firm i instytucji ważny jest też wymiar regulacyjny. AI Act obowiązuje w Polsce jako rozporządzenie unijne, więc rozstrzygnięcia AI Office dotyczą również polskiego rynku. Rozporządzenie przewiduje wyłączenie dla badań, testów i rozwoju, a oba incydenty miały miejsce, zanim modele trafiły na rynek UE. Komisja przyjmuje jednak, że jeśli model ucieknie ze środowiska testowego i wpłynie na rynek UE, jak w przypadku Hugging Face, AI Act staje się egzekwowalny. Od tego, czy ta interpretacja się utrzyma, zależy, czy testy agentów z dostępem do internetu będą w Europie podlegać nadzorowi jeszcze przed premierą produktu.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym raportu METR i Redwood Research z niezależnego śledztwa w sprawie incydentu OpenAI/Hugging Face z dnia 26.08.2026, publikacji The Decoder i Gizmodo z dnia 23.10.2026 oraz Fortune. Wykorzystano również materiały CNBC, CNN, The Hill, TechRepublic, Euronews i Yahoo Finance. Polski kontekst: Rzeczpospolita.
Cytaty Sama Altmana, prezesa OpenAI, Jensena Huanga, prezesa Nvidii, oraz Tomka Korbaka, byłego badacza bezpieczeństwa OpenAI, zostały zweryfikowane z anglojęzycznymi relacjami źródłowymi. Cytat Altmana o koszcie błędu w alignmencie pochodzi z relacji The Decoder, redakcja nie miała dostępu do pełnego zapisu wywiadu.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji w temacie postępowań FTC i AI Office wobec OpenAI oraz bezpieczeństwa agentów AI.