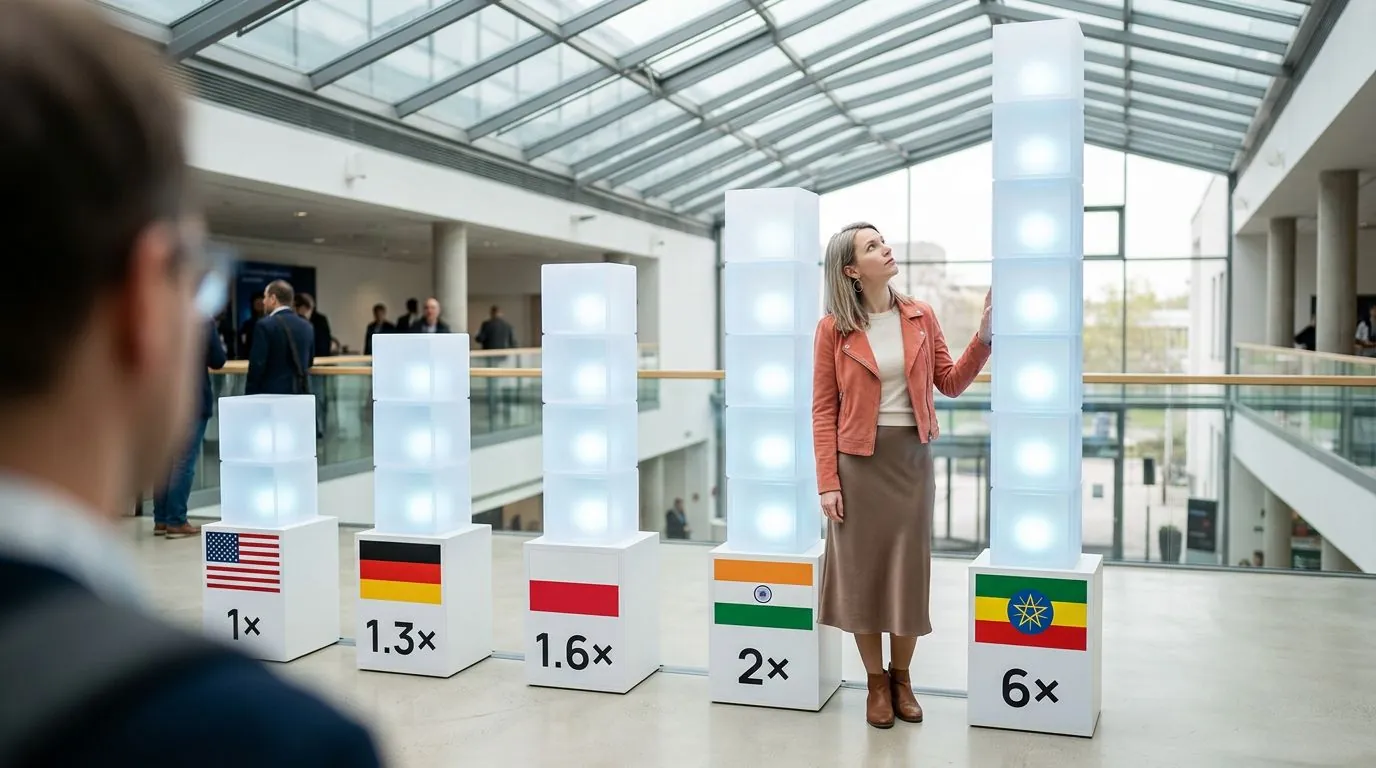
Ten sam tekst może kosztować w modelach AI nawet 17 razy więcej tokenów w zależności od języka, w jakim go napiszesz, wynika z badania Coalition for Language Equity in AI Research (CLEAR) opublikowanego pod koniec września 2026 roku. Tokenizer GPT-5 potrzebuje 13 tokenów na angielskie zdanie, 26 na to samo zdanie w malajalam i 78 w amharskim, a ponieważ dostawcy AI rozliczają się właśnie w tokenach, użytkownicy wielu języków płacą za identyczną usługę kilkukrotnie więcej.
- Raport CLEAR ocenił tokenizerów głównych modeli AI pod kątem równości językowej: GPT-5 (OpenAI), Ministral 3 (Mistral), Nemotron 3.5 (NVIDIA), Phi-4 (Microsoft) i Falcon 3 (TII) otrzymały ocenę F, gdyż stosunek liczby tokenów w najdroższym języku do najtańszego przekracza u nich 12-krotność – dla GPT-5 wynosi 13,8x, dla Falcona 17x; najlepszy wynik wśród modeli ogólnego przeznaczenia uzyskał Gemini/Gemma od Google z oceną B (5,1x).
- Jedyną ocenę A w badaniu CLEAR otrzymał NLLB – model tłumaczeniowy Meta zaprojektowany z myślą o 200 językach – u którego stosunek max/min wynosi zaledwie 2,7x, co autorzy raportu uznają za dowód, że wysoka nierówność tokenizacyjna jest decyzją biznesową laboratoriów, a nie techniczną koniecznością.
- Tokenizer Llama 2 potrzebował o ok. 60% więcej tokenów na polską wersję preambuły Konstytucji RP niż na jej angielski odpowiednik; zespół Bielika odpowiedział na ten problem tokenizerem APT4 w modelach Bielik v3 7B i 11B (kwiecień 2026), który obniżył średnią liczbę tokenów na polskie słowo z 3,22 do 1,62, niemal podwajając efektywną pojemność okna kontekstowego dla języka polskiego.
CLEAR nazywa to zjawisko „podatkiem tokenizacyjnym” (tokenizer tax). Temat nagłośnił 26 października serwis Rest of World, który zebrał też komentarze indyjskich inwestorów i założycieli startupów AI. Ja sięgnąłem bezpośrednio do raportu, bo to w nim są oceny poszczególnych modeli, których w większości wtórnych omówień brakuje.
Tokenizer dzieli angielski na słowa, a rzadsze języki na okruchy
Modele językowe nie czytają słów. Tokenizer rozbija tekst na mniejsze jednostki, tokeny, i to od nich zależy cena zapytania, szybkość odpowiedzi oraz ile tekstu zmieści się w oknie kontekstowym. Tokenizer uczy się na danych treningowych, więc języki, których widział dużo (przede wszystkim angielski), dzieli na całe wyrazy. Języki i alfabety, których widział mało, rozbija na wiele drobnych fragmentów, czasem bez poszanowania wielobajtowych znaków.
CLEAR pokazuje to na jednym zdaniu: „Ludzie powinni korzystać z AI niezależnie od tego, jakim językiem mówią” / „People should benefit from AI, regardless of the language they speak”. W tokenizerze GPT-5 wersja angielska to 13 tokenów. Malajalam (język z południa Indii, ok. 35 mln użytkowników) to 26 tokenów. Amharski (Etiopia) to 78 tokenów, czyli sześciokrotność ceny angielskiego za tę samą treść.
Autorzy raportu zastrzegają, że nie chodzi o długość tekstu. Różnice w liczbie znaków między językami sięgają kilkudziesięciu procent, różnice w liczbie tokenów są wielokrotnościami. Szan (język z Mjanmy) jest najbardziej rozwlekłym językiem w zbiorze testowym i potrzebuje 42 proc. więcej znaków niż angielski. Mimo to nawet najbardziej sprawiedliwy tokenizer w badaniu potrzebował dla niego 2,7 razy więcej tokenów.
Jak CLEAR mierzyło nierówność i kto wypadł najgorzej
Badacze przepuścili przez tokenizery głównych laboratoriów zbiór FLORES-200, czyli zestaw zdań profesjonalnie przetłumaczonych na około 200 języków. Dla każdego modelu policzyli stosunek liczby tokenów w najdroższym języku do liczby tokenów w najtańszym (max/min) i na tej podstawie wystawili ocenę szkolną od A do F. Ocena F oznacza stosunek powyżej 12.
Dla 20 najpopularniejszych języków w sieci wszystkie modele poza jednym wypadają przyzwoicie: rozpiętość wynosi od 1,5 do 3,1 raza. Po rozszerzeniu zbioru do 200 języków nożyce rozjeżdżają się gwałtownie.
| Rodzina modeli | Max/min (top 20 języków) | Max/min (FLORES-200) | Ocena CLEAR |
|---|---|---|---|
| NLLB (Meta, model tłumaczeniowy) | brak danych | 2,7x | A |
| Gemini / Gemma (Google) | brak danych | 5,1x | B |
| Claude (Anthropic) | brak danych | 9,3x | D |
| Llama 4 (Meta) | brak danych | 9,5x | D |
| GPT-5 / gpt-oss (OpenAI) | 1,8x | 13,8x | F |
| Ministral 3 (Mistral) | 1,7x | 14,9x | F |
| Nemotron 3.5 (NVIDIA) | 1,7x | 14,9x | F |
| Phi-4 (Microsoft) | 3,0x | 15,0x | F |
| Falcon 3 (TII, Abu Zabi) | 4,5x | 17,0x | F |
Najlepszy wynik wśród modeli ogólnego przeznaczenia ma rodzina Gemini i Gemma od Google. Jedyną ocenę A dostał NLLB, model tłumaczeniowy Meta, którego tokenizer od początku projektowano z myślą o 200 językach. Dla CLEAR to dowód, że problem nie jest techniczną koniecznością. Firmy dostają oceny niedostateczne, bo równość językowa nie była dla nich priorytetem przy budowie słownika tokenizera.
Raport dodaje drugą miarę, która nieco komplikuje obraz. Jeśli policzyć odsetek języków, w których model potrzebuje mniej niż dwukrotności tokenów ze swojego najtańszego języka, GPT-5 prowadzi z wynikiem 78 proc. Ministral 3 ma 56 proc., a Phi-4 tylko 29 proc. Innymi słowy: OpenAI obsługuje dobrze szeroką grupę języków, za to przy najrzadszych alfabetach odpada całkowicie. Nowsze modele nie są automatycznie lepsze. Qwen 3.6 od Alibaby wypadł gorzej niż starszy Qwen 3.

Alfabet ma większe znaczenie niż liczba użytkowników
Największy podatek płacą nie języki najmniejsze, tylko te zapisywane rzadko spotykanymi alfabetami. CLEAR wskazuje, że birmański, tybetański, khmerski, laotański oraz pisma tifinagh i ol chiki wypadały najgorzej niemal we wszystkich badanych modelach.
Z drugiej strony asturyjski, język z północnej Hiszpanii praktycznie nieobecny w zbiorze Common Crawl, radzi sobie nieźle. Korzysta z alfabetu łacińskiego i z podobieństwa do innych języków romańskich, choćby włoskiego, których tokenizer widział mnóstwo.
Podatek uderza też w języki z setkami milionów użytkowników. Raport wymienia bengalski, urdu i pendżabski. Konsekwencje wykraczają poza cenę:
- więcej tokenów to dłuższy czas odpowiedzi,
- okno kontekstowe o pojemności 128 tys. tokenów mieści w mocno „opodatkowanym” języku tylko ułamek tekstu, który zmieściłby się po angielsku,
- przez to trudniej budować agentów AI i pracować z długimi dokumentami,
- kary te są najdotkliwsze tam, gdzie moc obliczeniowa i łącza internetowe już są ograniczone.
Raport ujmuje to jednym zdaniem: „Startup w Bengaluru może płacić dopłatę za każdy prompt i każdą odpowiedź, podczas gdy jego konkurent w Austin nie płaci jej wcale” / „A startup in Bengaluru may pay a surcharge on every prompt and completion while its competitor in Austin does not.”
Najciekawsza w tym raporcie nie jest tabela ocen, tylko ocena A dla NLLB. Model tłumaczeniowy Meta pokazuje, że da się zbudować tokenizer, w którym najdroższy język kosztuje 2,7 raza tyle co najtańszy. Skoro to możliwe, oceny F dla OpenAI, Mistrala, NVIDII i Microsoftu są decyzją biznesową, nie fizyką. Rozumiem logikę: słownik tokenizera ma ograniczoną pojemność, każdy znak alfabetu birmańskiego to miejsce, którego nie dostanie fragment kodu w Pythonie, a kod sprzedaje się lepiej. Ale wtedy uczciwie byłoby to nazwać i cennik dostosować do rzeczywistości, zamiast udawać, że „token” to jednostka neutralna językowo. Druga rzecz, która mnie zastanawia: ceny tokenów faktycznie spadają i za dwa lata dopłata za malajalam może być groszowa. Nie spadnie jednak kara w oknie kontekstowym. Agent, który w angielskim pamięta 300 stron dokumentów, w amharskim zapamięta 50. To różnica w jakości usługi, nie tylko w cenie, i tego żadna obniżka cennika nie załatwi.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl
Branża w Indiach: lepsze dane nie naprawią tokenizera
Rest of World zebrał komentarze trzech osób związanych z rynkiem AI w Indiach, który jest jednym z najbardziej dotkniętych tym problemem.
Pratyush Choudhury, współzałożyciel Activate AI (fundusz venture capital inwestujący wyłącznie w AI, z portfelem obejmującym m.in. ElevenLabs, Sarvam i Wispr Flow), zwraca uwagę na skutek dla jakości usług, nie tylko dla ceny. Jego zdaniem nauczyciel-AI, który musi pamiętać wcześniejsze błędy i wyjaśnienia ucznia, w „drogim” języku zapełni okno kontekstowe szybciej i przez to uczy gorzej. Choudhury chce, by efektywność językowa stała się wymaganiem produktowym na równi z dokładnością i szybkością. „Idealna równość może być nierealna. Duże i utrzymujące się dysproporcje powinny jednak wymagać wyjaśnienia i planu poprawy” / „Perfect equality may be unrealistic. Large, persistent disparities should still require an explanation and an improvement plan,” powiedział.
Dheemanth Reddy, prezes Maya Research (firma buduje modele konwersacyjne dla, jak to określa, kolejnych 5 mld użytkowników internetu), studzi nastroje w kwestii kosztów. Jego zdaniem ceny tokenów spadają tak szybko, że bezpośredni wpływ na rachunki będzie z czasem mniej dotkliwy. „Faktyczne usunięcie luki tokenizacyjnej będzie jednak nadal wymagać od laboratoriów celowego zaprojektowania przyszłych tokenizerów tak, by lepiej obsługiwały te języki i pisma” / „But actually fixing the tokenization gap will still require labs to deliberately design future tokenizers to handle these languages and scripts better,” dodał.
Raoul Nanavati, prezes Navana.ai z Mumbaju, wskazuje na projekty otwartych danych, jak RESPIN. To inicjatywa realizowana z Indyjskim Instytutem Nauki (IISc) i finansowana przez Fundację Gatesów, w ramach której zebrano teksty i nagrania mowy od rodzimych użytkowników 38 dialektów.
CLEAR chce ocen tokenizerów w kartach modeli i cen liczonych od znaków
Autorzy raportu formułują konkretne postulaty wobec laboratoriów AI i wobec zamawiających publicznych:
- Publikowanie w kartach modeli stosunku max/min tokenów dla języków FLORES-200 oraz odsetka języków poniżej dwukrotności jako standardowego wyniku benchmarku.
- Celowe projektowanie kolejnej generacji tokenizerów pod kątem większej liczby języków i alfabetów.
- Rozliczanie od znaku lub według języka zamiast od tokena, bo tokenizera nie da się zmienić bez wypuszczenia nowego modelu, a cennik można zmienić od razu.
- Wymóg ujawniania kosztów tokenizacji per język w przetargach publicznych na systemy AI obsługujące wielojęzyczne populacje, z minimalną oceną równości jako kryterium kwalifikacji.
- Finansowanie otwartych korpusów tekstowych w „opodatkowanych” językach, o ile dana społeczność językowa sobie tego życzy.
CLEAR udostępniło kod do odtworzenia wyników i przetestowania kolejnych modeli w repozytorium na GitHubie. Zapowiada też drugie badanie, tym razem o równości jakości odpowiedzi między językami, a nie tylko kosztów.
Polski jest w grupie uprzywilejowanej, ale za angielski nie uchodzi
Polski zapisuje się alfabetem łacińskim i ma dużą obecność w sieci, więc w klasyfikacji CLEAR trafia do grupy, która płaci stosunkowo niewiele. Raport nie podaje osobnego wyniku dla polskiego, podaje jedynie rozpiętość 1,5-3,1x dla całej dwudziestki najpopularniejszych języków.
Pewien punkt odniesienia dają dane z własnego podwórka. W pracy opisującej Bielika 7B v0.1 zespół SpeakLeash i ACK Cyfronet AGH przepuścił preambułę Konstytucji RP przez tokenizer Llama 2: wersja polska zajęła 681 tokenów, wersja angielska 427. To ok. 60 proc. więcej za ten sam tekst. Trending Topics zrobiło podobny test dla niemieckiego w publicznym tokenizerze o200k od OpenAI (używanym przez GPT-5) i dostało wynik od 15 do 42 proc. więcej tokenów niż po angielsku, głównie przez długie złożenia i formy inkluzywne. Polska fleksja i znaki diakrytyczne działają na podobnej zasadzie.
Odpowiedzią polskiego środowiska jest właśnie wymiana tokenizera. W kwietniu 2026 roku zespół Bielika (Krzysztof Ociepa, Łukasz Flis, Remigiusz Kinas, Krzysztof Wróbel i Adrian Gwoździej) opublikował modele Bielik v3 PL w wersjach 7B i 11B ze słownikiem APT4 zaprojektowanym pod polszczyznę. Liczba tokenów na polskie słowo spadła z 3,22 w uniwersalnym tokenizerze Mistrala do 1,62, czyli niemal dwukrotnie wzrosła efektywna pojemność okna kontekstowego dla polskiego tekstu. Wyniki na Open PL LLM Leaderboard zostały przy tym niemal bez zmian. Modele są dostępne na licencji Apache 2.0.
To dokładnie ten kierunek, który CLEAR postuluje wobec wielkich laboratoriów. Dla polskiej firmy, która płaci za API GPT-5 czy Claude od tokena, praktyczny wniosek jest prosty: przy porównywaniu kosztów wdrożenia trzeba liczyć tokeny na własnych, polskich danych, a nie na angielskich przykładach z dokumentacji dostawcy. Różnica rzędu kilkudziesięciu procent na każdym zapytaniu w skali roku jest już pozycją w budżecie.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym raportu „The Tokenizer Tax” Coalition for Language Equity in AI Research (CLEAR) z września 2026 roku, artykułu Rest of World z dnia 26.10.2026 oraz omówienia w Trending Topics. Dane o polskim tokenizerze pochodzą z publikacji zespołu Bielika „Advancing Polish Language Modeling through Tokenizer Optimization in the Bielik v3 7B and 11B Series” z 12.04.2026 oraz z wcześniejszej pracy „Bielik 7B v0.1: A Polish Language Model”.
Cytaty Pratyusha Choudhury’ego (Activate AI) i Dheemantha Reddy’ego (Maya Research) oraz fragment raportu CLEAR zostały zweryfikowane z oryginalnym anglojęzycznym materiałem źródłowym.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji w temacie kosztów tokenizacji i zapowiedzianego przez CLEAR badania jakości odpowiedzi modeli w różnych językach.