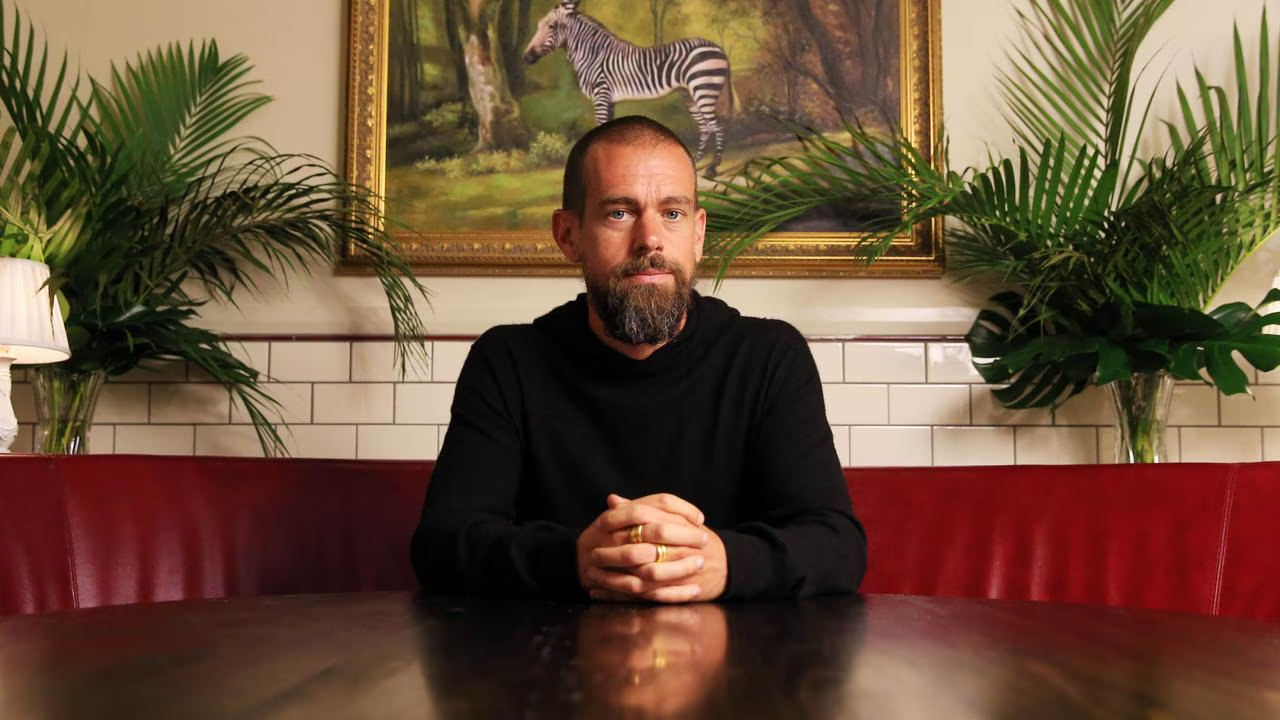
Block, firma Jacka Dorseya znana z Square i Cash App, zaprezentowała 23 października 2026 roku Dessę, model mowy, który według firmy nauczył się rozmawiać wyłącznie z nagrań ludzkich konwersacji, bez tekstu i bez żadnego wcześniej wytrenowanego modelu językowego. Dessa słucha i mówi jednocześnie, śmieje się, robi pauzy i zmienia ton głosu, została wytrenowana na jednej szafie serwerowej Nvidia GB200 NVL72 i działa lokalnie na MacBooku Pro z układem M4 Max.
- Block zaprezentował 23 października 2026 roku Dessę – model mowy wytrenowany wyłącznie na nagraniach ludzkich rozmów, bez tekstu i bez żadnego wcześniej wytrenowanego modelu językowego, który działa lokalnie na MacBooku Pro z układem M4 Max.
- Dessa jest pełnodupleksowa (słucha i mówi jednocześnie), a cały jej trening odbył się na jednej szafie serwerowej Nvidia GB200 NVL72 – Block twierdzi, że model nauczył się języka z setek razy mniejszej liczby słów niż potrzebują duże modele językowe.
- Block nie ujawnił rozmiaru modelu, wyników na żadnych benchmarkach ani daty publicznego udostępnienia – dostęp do Dessy ma wyłącznie niewielka grupa zewnętrznych badaczy bezpieczeństwa AI, a wszystkie dostępne materiały o jej możliwościach to nagrania wybrane przez samą firmę.
Na razie nikt spoza Blocka nie może jej przetestować. Firma udostępnia model wyłącznie niewielkiej grupie badaczy bezpieczeństwa AI, a wszystko, co wiemy o jego możliwościach, pochodzi z nagrań opublikowanych przez samą firmę.
Zapowiedź Jacka Dorseya: https://twitter.com/jack/status/2113697902916751661
We believe voice is the most natural way to interact with intelligence, so we created Dessa, the most authentic full-duplex speech model ever built. Talking with it feels like talking with a person…full of emotion, nuance, pauses, and a natural cadence. https://t.co/r0qFLdvd6c
— jack (@jack) October 23, 2026
Wpis zespołu Dessa z przykładami rozmów: https://twitter.com/RagavanThurair/status/2113671324400861645
We made the first AI model you can have a realistic conversation with that was trained entirely on speech!
Dessa is a full-duplex speech-to-speech model that you can run on consumer GPUs.
This is a GPT3 moment for speech. pic.twitter.com/XVD8sSyJn8
— Ragavan Thurairatnam (@RagavanThurair) October 23, 2026
Dessa uczy się mówić tak, jak dziecko: ze słuchu, bez czytania
Najważniejsza różnica między Dessą a dotychczasowymi asystentami głosowymi dotyczy tego, co trafia do modelu i co z niego wychodzi. Block opisuje Dessę jako prawdziwy model „mowa do mowy” (speech-to-speech): dźwięk wchodzi, dźwięk wychodzi, bez zamiany na tekst po drodze.
Typowy asystent głosowy działa inaczej. Zamienia głos użytkownika na tekst, przekazuje tekst do dużego modelu językowego, a odpowiedź modelu zamienia z powrotem na mowę. Każdy z tych etapów gubi informacje, których tekst nie jest w stanie przenieść: zmęczenie, wahanie, irytację, radość. Block pisze o tym wprost we wpisie na swojej stronie i uzasadnia tym cały projekt.
„Najpotężniejsze AI na świecie nie słyszą, jak się czujesz” / „The most powerful AIs in the world can’t hear how you feel”
To zdanie z komunikatu Blocka. Firma dodaje, że uważa taki stan za niedorzeczny, prowadzący do gorszych doświadczeń i potencjalnie niebezpieczny.
Z opisu firmy wynika kilka konkretnych cech modelu:
- dane treningowe to wyłącznie nagrania ludzkich rozmów, bez tekstu i bez modelu bazowego,
- model jest pełnodupleksowy (full-duplex), czyli słucha i mówi w tym samym czasie, więc radzi sobie z wtrąceniami i przerywaniem,
- wiedza modelu pochodzi wyłącznie z rozmów, na których go trenowano, bez podłączonego modelu językowego,
- trening odbył się na jednej szafie Nvidia GB200 NVL72,
- model działa szybciej niż w czasie rzeczywistym na MacBooku Pro z układem M4 Max lub mocniejszym,
- Block twierdzi, że Dessa nauczyła się języka z setek razy mniejszej liczby słów niż potrzebują duże modele językowe.
Block zastrzega na swojej stronie, że „o ile wiadomo firmie” Dessa jest pierwszym modelem AI zdolnym do realistycznej rozmowy na żywo wytrenowanym wyłącznie na ludzkiej mowie. Ragavan Thurairatnam, który kieruje zespołem Dessa, poszedł w swoim wpisie dalej i nazwał premierę „momentem GPT-3 dla mowy” / „a GPT3 moment for speech”.
Nagrania pokazują śmiech, zmęczenie i grę w zgadywanki, choć nie ma żadnych benchmarków
W opublikowanych przez Block nagraniach Dessa śmieje się w połowie zdania, reaguje na niespodziankę i zmienia ton głosu, gdy mówi o zmęczeniu po pracy. Firma zapewnia, że rozmowy nagrano na żywo i nikt nie sterował odpowiedziami modelu. W jednym z nagrań członkini zespołu Blocka gra z Dessą w zgadywanki, w innym model rozmawia z GPT-Live, głosowym modelem OpenAI.
TechCrunch zwraca uwagę na jeden nierozstrzygnięty szczegół. Modele takie jak ElevenLabs v4 czy Fish Audio Drama 3 sterują emocjami przez specjalne znaczniki w tekście. Block twierdzi, że w Dessie emocje są wbudowane w model, nie ujawnił jednak, czy jakakolwiek forma znaczników bierze udział w generowaniu mowy.
Lista rzeczy, których Block nie podał, jest dłuższa niż lista tego, co podał:
- rozmiar modelu,
- wyniki na jakichkolwiek benchmarkach,
- data publicznego udostępnienia,
- czy i kiedy wagi modelu zostaną otwarte,
- jak długo trwał trening i na jakiej liczbie godzin nagrań.
Nagrania pozostają demonstracją firmy, nie niezależnym testem. To ważne zastrzeżenie, bo cała dyskusja wokół Dessy opiera się na materiale wybranym przez jej twórców.

Za Dessą stoi małe laboratorium z Toronto, które Square kupił w 2020 roku
Nazwa modelu nie jest przypadkowa. Dessa to także nazwa kanadyjskiego startupu zajmującego się uczeniem głębokim, który Square (poprzednia nazwa Blocka) przejął w 2020 roku. Według CoinDesk laboratorium badawcze AI w Blocku podlega bezpośrednio Dorseyowi i skupia byłych pracowników tej firmy z Toronto.
Block to przede wszystkim firma płatnicza. Prowadzi system Square dla małych firm, aplikację Cash App, portfel bitcoinowy Bitkey i dział sprzętu do kopania bitcoina Proto. Square już dziś korzysta z głosowej AI do przyjmowania zamówień w gastronomii. TechCrunch ocenia, że własny model głosowy działający lokalnie na urządzeniu pozwoliłby Blockowi obsłużyć znacznie więcej scenariuszy biznesowych i konsumenckich przy niższych kosztach.
Najciekawsza w tej premierze nie jest dla mnie jakość nagrań. Najciekawsza jest teza badawcza. Jeśli model wytrenowany wyłącznie na dźwięku, na jednej szafie serwerowej, potrafi prowadzić rozmowę na poziomie pokazanym w demach, to ktoś właśnie podważył założenie, że droga do naturalnej mowy wiedzie przez gigantyczne modele tekstowe i dziesiątki tysięcy akceleratorów.
Widzę jednak dwa problemy. Pierwszy: Block nie pokazał ani jednej liczby. Kilkanaście nagrań dobranych przez autorów to materiał marketingowy, nie dowód. Sam Dorsey ma historię efektownych zapowiedzi, które potem długo czekały na produkt. Drugi problem jest poważniejszy. Model bez tekstu nie ma naturalnego sposobu, żeby przeczytać dokument, wywołać API czy sprawdzić fakt. Dessa wie tyle, ile usłyszała. To wystarczy do rozmowy o filmie. Nie wystarczy do pracy asystenta, który ma coś załatwić.
I jeszcze jedno. Block sam przyznaje, że najpierw oddaje model badaczom bezpieczeństwa. Głos nieodróżnialny od ludzkiego, działający lokalnie na laptopie, to dokładnie to narzędzie, o którym marzą oszuści telefoniczni. Pytanie, czy Block ma plan na moment, w którym taki model wycieknie albo ktoś odtworzy go na własnych danych, bo to się wydarzy.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl
Reakcje: zachwyt nad realizmem i strach przed telefonicznymi oszustwami
Nagrania Dessy szybko rozeszły się w mediach społecznościowych i podzieliły komentujących. Część użytkowników X pisała, że nigdy nie słyszała sztucznego głosu brzmiącego tak ludzko. Changpeng „CZ” Zhao, założyciel Binance, zobaczył w modelu zastosowanie dla swojego projektu edukacyjnego GiggleAcademy i napisał, że uczenie dzieci przy pomocy dotychczasowych głosów AI było wyzwaniem.
Druga grupa reakcji dotyczy nadużyć. Reżyserka Justine Bateman zapytała, po co głosom AI brzmieć jak ludzie, i sama odpowiedziała: „Żeby oszukać ludzi i uśpić ich czujność” / „So you can trick people into lowering their guard”. Dziennikarz Shiv Aroor napisał, że oszukańcze telefony zaraz osiągną „poziom pandemii”.
Block przewidział tę dyskusję. Firma argumentuje, że model słyszący emocje może w przyszłości lepiej rozpoznawać sygnały cierpienia lub bólu, które giną w transkrypcji, i że właśnie dlatego zaprasza zewnętrznych badaczy do sprawdzenia ryzyk, których sama mogła nie dostrzec.
Dessa wchodzi w rynek, na którym OpenAI i ElevenLabs grają od miesięcy
Pełnodupleksowa rozmowa nie jest już nowością. OpenAI udostępniło w lipcu 2026 roku model GPT-Live, który również słucha i mówi jednocześnie. ElevenLabs wydało 28 września 2026 roku model Eleven v4 oraz jego szybszą wersję v4 Turbo, przeznaczoną dla agentów głosowych działających w czasie rzeczywistym, z obsługą ponad 90 języków.
Różnica między tymi modelami a Dessą leży w architekturze. GPT-Live i Eleven v4 opierają się na tekście w którymś miejscu procesu. Dessa, według Blocka, nie widziała tekstu nigdy. Z tego wynika też jej największe ograniczenie: nie wiadomo, jak sprawnie taki model uczy się faktów i nowych języków w porównaniu z modelami tekstowymi. Block wymienia to pytanie na własnej stronie jako otwarty problem badawczy.
Akcje Blocka (ticker XYZ) kosztowały po premierze około 74-75 dolarów. Notowania nie zareagowały na ogłoszenie w sposób, który wskazywałby, że rynek traktuje Dessę jako produkt, a nie eksperyment.
Polska zna już skutki realistycznych głosów AI, zanim Dessa trafi do kogokolwiek
Dessa nie jest dostępna w Polsce ani nigdzie indziej. Debata, którą wywołała, dotyczy jednak zjawiska, które w Polsce trwa od kilku lat. Demagog w swojej analizie wskazuje, że w Polsce klonowanie głosu wykorzystują przede wszystkim oszuści reklamujący fałszywe inwestycje, a nie, jak w USA czy Wielkiej Brytanii, osoby bawiące się polityką. Głośnym przykładem było nagranie z listopada 2023 roku, w którym wygenerowany głos Aleksandra Kwaśniewskiego namawiał do inwestowania pieniędzy.
Polski wątek ma też drugą stronę. ElevenLabs, jeden z najważniejszych graczy na rynku syntezy mowy i bezpośredni punkt odniesienia dla Dessy, zostało założone przez Polaków, Mateusza Staniszewskiego i Piotra Dąbkowskiego, i utrzymuje w Warszawie znaczącą część zespołu. Jeśli podejście Blocka (trening wyłącznie na dźwięku) okaże się skuteczne, to właśnie polska firma będzie jedną z pierwszych, które będą musiały na nie odpowiedzieć.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym oficjalnej strony modelu Dessa opublikowanej przez Block z dnia 23.10.2026, wpisu Jacka Dorseya na X z dnia 23.10.2026 oraz relacji TechCrunch i CoinDesk. Polski kontekst dotyczący nadużyć klonowania głosu pochodzi z analizy Demagoga.
Cytaty Jacka Dorseya (współzałożyciel i szef Block), Ragavana Thurairatnama (szef zespołu Dessa), Justine Bateman oraz komunikatu Block zostały zweryfikowane z oryginalnym anglojęzycznym materiałem źródłowym.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji o modelu Dessa i jego publicznej dostępności.