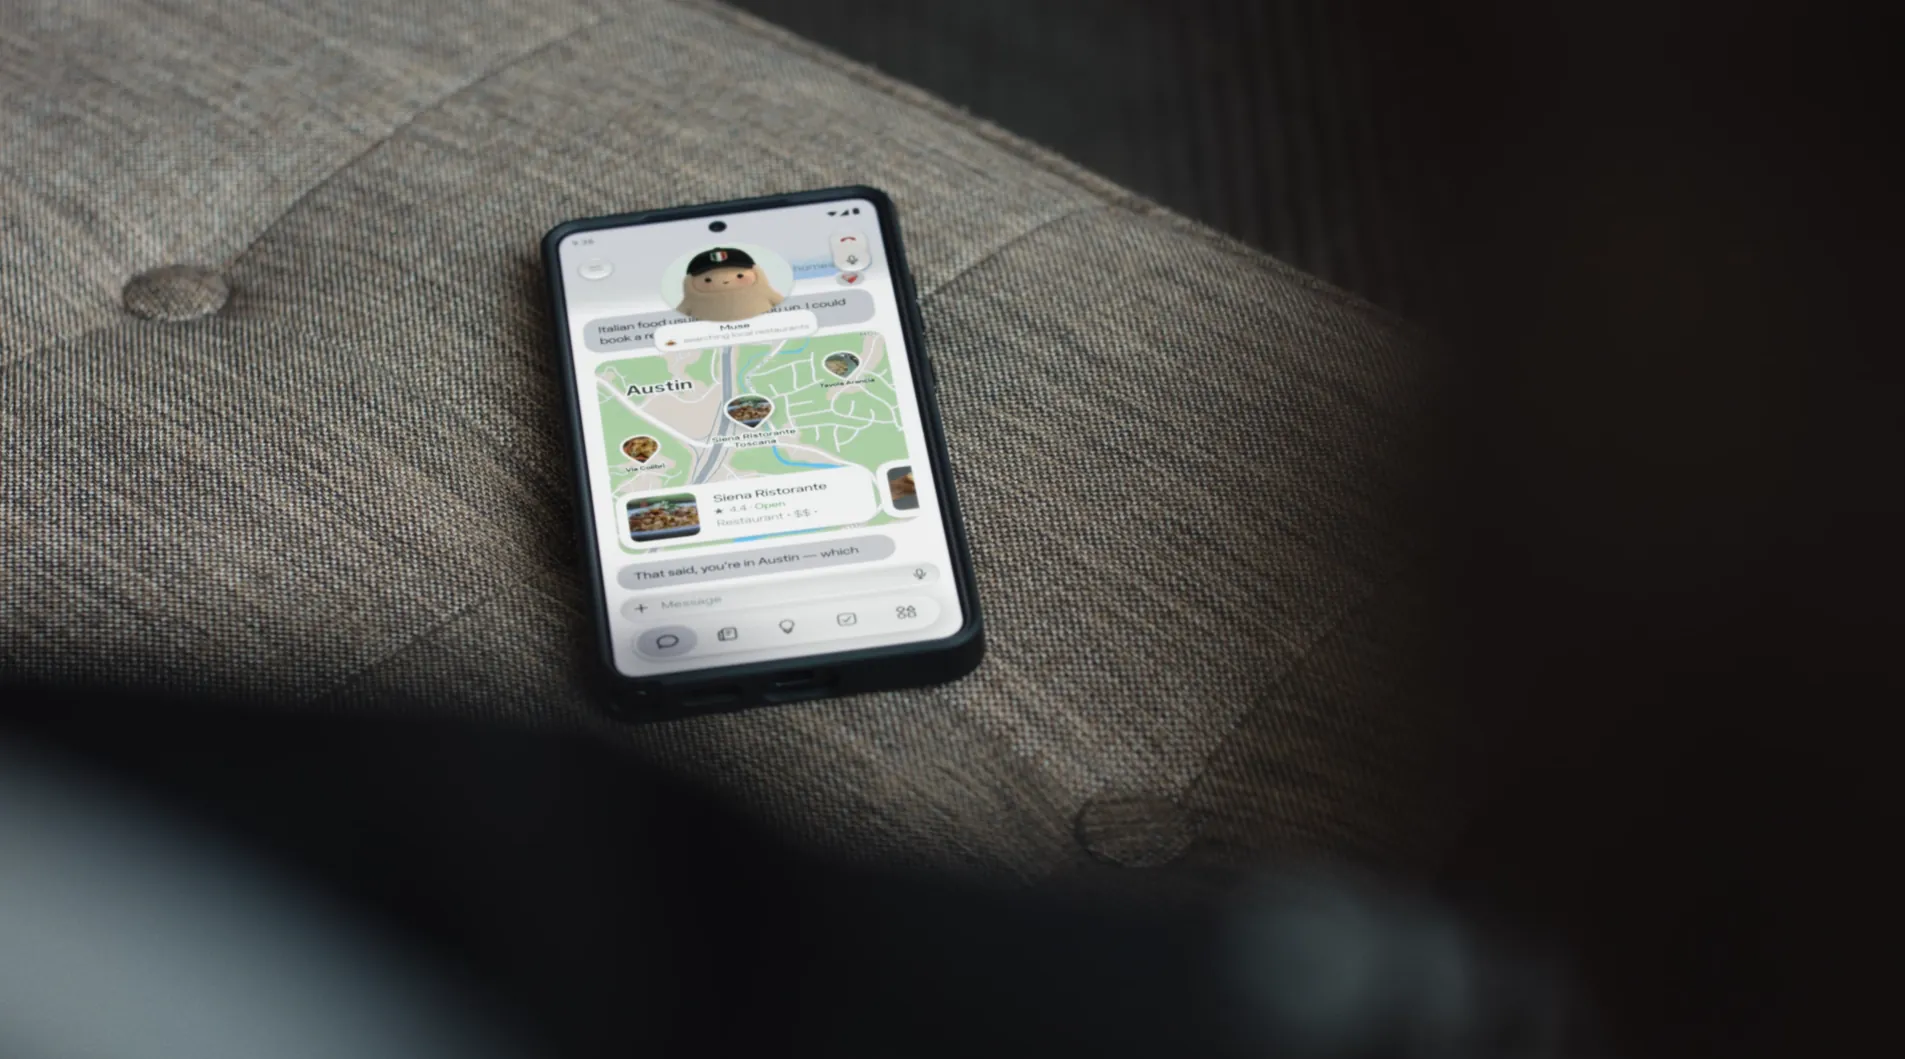
Meta udostępnia w aplikacji Muse rozmowy głosowe w czasie rzeczywistym oraz awatary, które reagują mimiką i gestami na przebieg rozmowy. Funkcje trafiają 5 listopada 2026 roku do użytkowników w USA na telefonach, w przeglądarce i na Macu, przy czym agent może w trakcie rozmowy wykonywać zadania w tle.
- 5 listopada 2026 roku Meta udostępniła użytkownikom w USA rozmowy głosowe w czasie rzeczywistym (Muse Realtime Voice) oraz animowane awatary (Muse Realtime Avatar) w aplikacji Muse – funkcje zapowiedziane pierwotnie na konferencji Meta Connect 2026 w dniu 23 września 2026 roku.
- System awatara generuje wideo w rozdzielczości 448 x 768 pikseli z prędkością 25 klatek na sekundę, z opóźnieniem odpowiedzi wynoszącym ok. 870 ms, a dzięki destylacji modelu liczba przebiegów obliczeniowych spadła z 120 do 2, co pozwala obsłużyć 12 jednoczesnych sesji na jednej karcie NVIDIA GB200.
- W teście przeprowadzonym przez samą Meta awatar Muse uzyskał wyższe oceny niż Runway Characters (78 do 22 proc.) i HeyGen LiveAvatar (88 do 12 proc.), przy czym niezależnego testu potwierdzającego te wyniki dotychczas nie opublikowano.
Rozmowę uruchamia ikona telefonu w prawym górnym rogu aplikacji. Według opisu przekazanego przez Meta i zrelacjonowanego przez Unite.AI użytkownik może zostać przy samym głosie, ustawić awatara obok okna rozmowy albo przełączyć się na pełnoekranowy widok twarzą w twarz.
Meta pokazała obie technologie po raz pierwszy 23 września 2026 roku na konferencji Meta Connect 2026. Wtedy była to zapowiedź i demonstracja. Teraz funkcje trafiają do realnych użytkowników.
Muse Realtime Voice pozwala przerywać agentowi, który dalej pracuje w tle
Muse Realtime Voice odpowiada od razu na głos i pozwala wejść agentowi w słowo, tak jak w zwykłej rozmowie. Najważniejsza zmiana polega na tym, że zlecone zadania nie wstrzymują rozmowy: Muse może je wykonywać w tle, podczas gdy użytkownik dalej mówi.
Meta podaje przykłady zastosowań:
- rozwijanie niedopracowanego pomysłu bez pisania precyzyjnego polecenia,
- planowanie podróży na podstawie celu i kilku preferencji,
- przygotowanie do rozmowy o pracę, prezentacji albo rozmowy z inwestorem,
- zlecanie zadań w czasie spaceru lub gotowania.
Do wyboru są setki głosów, które można zmieniać. Meta ilustruje ten wybór między innymi energicznym stylem nowojorczyka i głosem pirata.
Głos rozszerza produkt, który Meta zbudowała wokół wiadomości i delegowania zadań. Muse wystartował 8 września 2026 roku jako osobisty agent AI dostępny w aplikacji Muse i przez WhatsAppa. Agent wysyła e-maile, rezerwuje podróże, pracuje po zamknięciu aplikacji i wraca do użytkownika, gdy coś się zmieni albo gdy potrzebuje zgody na wrażliwą operację, na przykład zakup. Rozmowy głosowe i awatar dokładają do tego modelu mowę i obecność wizualną.
Głos i twarz awatara powstają z jednego strumienia danych
Muse Realtime Voice i Muse Realtime Avatar działają jako jeden system strumieniowy, co Meta opisała we wpisie badawczym „Bringing Your Muse to Life” z 23 września 2026 roku. Model głosowy generuje tokeny mowy, które niosą zarówno treść wypowiedzi, jak i sposób jej wygłoszenia. Dekoder audio zamienia je na dźwięk. Model awatara korzysta z tego samego strumienia, żeby wygenerować obraz.
„Współdzielenie tego strumienia tokenów utrzymuje synchronizację głosu, ruchu ust i mimiki” / „Sharing this token stream keeps voice, lip motion, and expression synchronized”, piszą badacze Meta.
Muse Realtime Avatar to model typu Diffusion Transformer (architektura generatywna stosowana w modelach obrazu i wideo) sterowany dźwiękiem. Model przyjmuje trzy rodzaje danych: strumień tokenów mowy, materiał referencyjny, czyli na przykład portret lub ilustrację, oraz przesuwające się okno ostatnio wygenerowanych klatek. Wideo powstaje w krótkich fragmentach. Najnowsze dane z każdego zakończonego fragmentu stają się punktem wyjścia dla kolejnego, dzięki czemu awatar zachowuje wygląd i manieryzmy przez całą rozmowę, a koszt obliczeń nie rośnie wraz z jej długością.
Meta podaje parametry systemu:
| Parametr | Wartość według Meta |
|---|---|
| Rozdzielczość wideo | 448 x 768 pikseli (format pionowy) |
| Liczba klatek | 25 na sekundę |
| Opóźnienie odpowiedzi | ok. 870 ms od końca wypowiedzi użytkownika |
| Liczba przebiegów modelu na fragment | 2 zamiast 120 (60 razy mniej) |
| Sesje na jednym GPU NVIDIA GB200 | 12 jednoczesnych |
| Wzrost przepustowości | 8-krotny wobec wyjściowej wersji BF16 |
Redukcję obliczeń osiągnięto przez destylację, czyli wytrenowanie mniejszego i szybszego modelu „ucznia” na wynikach dokładniejszego modelu „nauczyciela”. Nauczyciel potrzebował 40 kroków dyfuzji, każdy z trzema przebiegami modelu. Uczeń robi to samo w dwóch przebiegach. W teście preferencji przeprowadzonym przez Meta oceniający rozkładali głosy niemal po równo (45 do 55 proc.) między uczniem a nauczycielem.

Meta twierdzi, że jej awatar wygrywa z Runway i HeyGen
Muse Realtime Avatar wypadł lepiej od dwóch komercyjnych systemów awatarów w teście, który Meta przeprowadziła sama. Oceniający prowadzili dwu-, trzyminutowe rozmowy z każdym systemem przy tych samych tożsamościach awatarów. W ocenie ogólnej awatar Meta wygrał z Runway Characters w proporcji 78 do 22 proc. oraz z HeyGen LiveAvatar w proporcji 88 do 12 proc.
Meta zaznacza, że w kategorii manieryzmów różnica wobec Runway Characters nie była istotna statystycznie. Niezależnego testu na razie nie opublikowano. Trzeba też pamiętać o różnicy w dostępie: Runway i HeyGen sprzedają swoje awatary przez API, z którego mogą korzystać inne firmy. Muse Realtime Avatar działa wyłącznie wewnątrz aplikacji Muse i Meta nie zapowiedziała dla niego interfejsu dla deweloperów.
Przyglądam się temu wdrożeniu z dwóch stron. Technicznie robi wrażenie: 870 milisekund opóźnienia i dwanaście sesji wideo na jednej karcie GB200 to wynik, który pozwala myśleć o awatarze dla milionów ludzi, a nie dla garstki testerów. Bez takiej wydajności generowane na żywo wideo zostałoby kosztowną ciekawostką z konferencji.
Mam jednak pytanie, które Meta zostawia bez odpowiedzi. Muse to agent z dostępem do poczty, kalendarza i płatności. Dodanie mu twarzy, mimiki i setek głosów nie zwiększa jego kompetencji. Zwiększa za to zaufanie, jakim go darzymy, i to zaufanie budowane na emocjach, nie na sprawdzeniu, co agent faktycznie zrobił. Firma, której model biznesowy od lat opiera się na uwadze użytkowników, dostaje narzędzie do budowania więzi z rozmówcą.
Uważam, że to dobry moment, żeby zapytać, gdzie przebiega granica między wygodnym interfejsem a projektowaniem przywiązania. Znak wodny w wideo jest krokiem w dobrą stronę. Nie odpowiada jednak na pytanie, czy chcemy, żeby agent z kluczami do naszych kont patrzył na nas sympatyczną twarzą.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl
Każde wideo z awatara dostaje niewidoczny znak wodny Video Seal
Meta osadza w każdym wygenerowanym nagraniu awatara trwały, niewidoczny znak wodny Meta Video Seal. Według wpisu badawczego znak nie wydłuża czasu odpowiedzi. Firma zastrzega też, że przykłady z publikacji pokazują możliwości modelu i nie wszystkie odpowiadają awatarom dostępnym w aplikacji. Z Muse mogą korzystać wyłącznie osoby pełnoletnie.
Rozmowy głosowe mają wkrótce trafić także do okularów AI Meta i do Muse Charm, małego urządzenia do noszenia przy sobie, zaprojektowanego do rozmów z agentem. Na Connect Meta opisała dostęp przez okulary jako obsługę bez użycia rąk. Daty premiery tych wersji firma nie podała.
Muse nadal nie działa w Polsce
Polscy użytkownicy nie skorzystają na razie ani z agenta Muse, ani z nowych rozmów głosowych. Obecne wdrożenie dotyczy wyłącznie USA. Sam Muse działa w kilku krajach poza Europą: po Stanach Zjednoczonych trafił do Kanady, a 23 października 2026 roku Meta ogłosiła jego premierę w Japonii. Daty dla Unii Europejskiej firma nie przedstawiła.
Polska ma w tej historii znajomy scenariusz. Asystent Meta AI dotarł do Polski i ponad 40 innych krajów europejskich z dużym opóźnieniem wobec USA, a na start działał w ograniczonym zakresie i bez języka polskiego. W przypadku Muse barier może być więcej. Agent z dostępem do poczty i płatności, który dodatkowo generuje wideo z ludzką twarzą, w Unii Europejskiej trafi pod przepisy RODO oraz pod obowiązki przejrzystości z AI Act dotyczące oznaczania treści generowanych przez AI. Znak wodny Video Seal może pomóc Meta spełnić część tych wymogów. Nie przesądza jednak o tym, kiedy i w jakim kształcie Muse pojawi się w Polsce.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym wpisu badawczego Bringing Your Muse to Life Meta AI Research z dnia 23.09.2026, publikacji Unite.AI z dnia 05.11.2026 oraz TechCrunch z dnia 23.09.2026. Informacje o dostępności Muse zweryfikowano także w materiałach TestingCatalog i DataCamp. Kontekst dostępności Meta AI w Europie: PAP.
Cytat zespołu Meta AI Research został zweryfikowany z oryginalnym anglojęzycznym materiałem źródłowym.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji o rozmowach głosowych w Muse oraz dostępności agenta w Polsce.