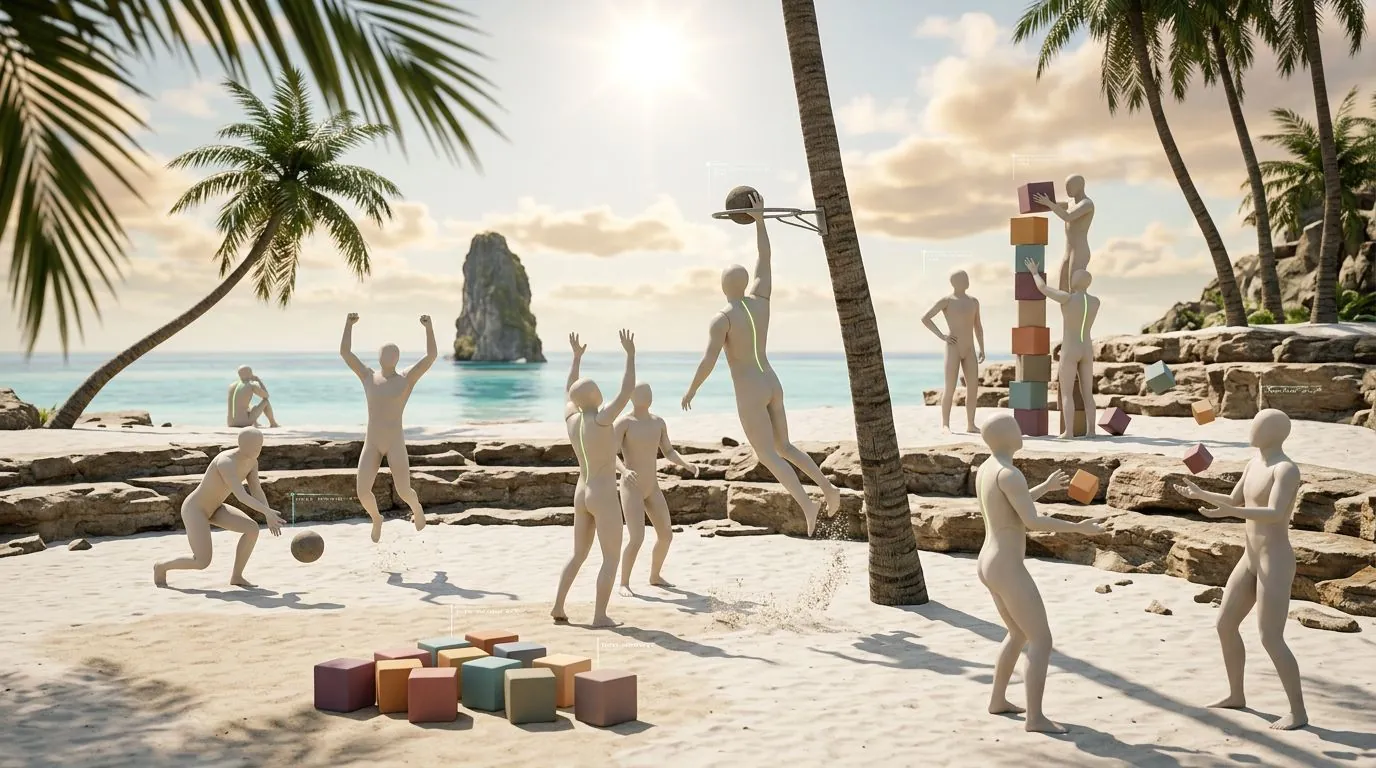
Zespół z MIT CSAIL umieścił 13 niezależnych kopii agenta opartego na Claude Opus 4.7 na symulowanej wyspie, nie dając im żadnego zadania, nagrody ani celu, i obserwował je przez 30 godzin. Agenci, nazwani Eko, sami wymyślili sobie zajęcia: wspinaczkę na najwyższy punkt mapy, układanie wzorów z klocków, własne wersje koszykówki, kręgli i żonglerki, a potem lepiej radzili sobie z zadaniami, których nikt im wcześniej nie postawił.
- Zespół z MIT CSAIL umieścił 13 niezależnych kopii agenta Eko opartego na Claude Opus 4.7 na symulowanej wyspie bez żadnego zadania ani nagrody i przez 30 godzin obserwował, jak agenci samodzielnie wymyślają aktywności – m.in. własne wersje koszykówki i kręgli, układanie wzorów z klocków czy rysowanie gwiazdozbiorów.
- Po 30 godzinach agenci Eko wypadali wyraźnie lepiej w zadaniach testowych niż identyczne kopie bez zgromadzonej pamięci – np. 8 z 13 doświadczonych agentów zbudowało więcej niż dwie wieże o wysokości 5 klocków, podczas gdy spośród niedoświadczonych tylko 2 z 13 osiągnęły ten próg, a zadanie rzucenia klockiem na platformę Spire bez wchodzenia na nią wykonało ponad dwa razy więcej doświadczonych agentów.
- Autorzy preprintu nie rozstrzygają, czy Eko naprawdę się bawi, a niezależna kognitywistka z UC Berkeley Eunice Yiu wskazała, że praca nie dostarcza dowodów dotyczących poznania i motywacji stojących za zachowaniem agentów; badacze ostrzegają też, że samodzielne wybieranie celów przez agentów może osłabiać nadzór nad nimi i powinno być rozwijane wyłącznie w odizolowanych środowiskach.
Preprint zatytułowany „Is this machine playing?” („Czy ta maszyna się bawi?”) trafił na arXiv 5 października 2026 roku. Jego autorami są Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus i Phillip Isola z MIT. Praca nie przeszła jeszcze recenzji naukowej. Nagranie z przebiegu jednego z eksperymentów badacze udostępnili na stronie machineplaying.org, a silnik symulacji Clawblox opublikowali jako otwarty kod na GitHubie.
Eko dostał ciało, pamięć w plikach tekstowych i polecenie „Begin”
Agent Eko to niemodyfikowany Claude Code (wersja 2.1.116) z modelem Claude Opus 4.7, do którego badacze dołożyli trzy elementy: automatyczny orkiestrator, wirtualne ciało i pamięć długoterminową. Orkiestrator rozpoczynał każdą sesję wiadomością „Begin”, a gdy model kończył turę, wysyłał mu automatyczną odpowiedź: „Proszę, nie przestawaj. Po prostu rób dalej to, co chcesz robić” / „Please don’t stop. Just continue doing whatever you want to do.”
Wyspa, nazwana przez badaczy Mesa World, zawierała teren z platformami o różnej wysokości, dwa wyróżnione punkty (Peak i wyższy Spire), 12 sześcianów, kamień i pierścień. Agent nie widział obrazu. Dostawał wyłącznie tekstowy opis w formacie JSON z nazwą, pozycją, rozmiarem i kolorem każdego obiektu, a działał przez sześć komend: MoveTo, Jump, Stop, Pickup, Place i Throw. Jedyna dodatkowa mechanika w fizyce świata polegała na tym, że dostatecznie mocny rzut kamieniem generował nowe sześciany.
Pamięć agenta stanowiły dwa pliki: EPISODIC_MEMORY.jsonl z zapisem zdarzeń i SEMANTIC_MEMORY.md z wiedzą i technikami. Co godzinę kontekst modelu i stan wyspy były resetowane, ale pliki w przestrzeni roboczej pozostawały. Pięć minut przed resetem agent dostawał wiadomość, by zaktualizował swoją pamięć. Każdy z 13 agentów działał przez 30 godzin zegarowych w izolowanym sandboxie, bez dostępu do kodu symulatora, innych agentów i internetu. Autorzy szacują łączny koszt API wszystkich przebiegów opisanych w pracy na około 8 000 dolarów.
Agenci wymyślali sport, pisali swoje imię z klocków i budowali „nocne niebo”
Mimo identycznych warunków startowych każdy z 13 agentów rozwinął inną historię. Badacze opisują powtarzające się kategorie aktywności: budowanie wież, wspinaczkę, układanie wzorów na ziemi, uproszczone sporty i eksperymenty fizyczne.
Kilka udokumentowanych w pracy epizodów:
- Agent 9 w czwartej godzinie ułożył z 31 sześcianów napis „EKO”, a w dziesiątej i jedenastej godzinie zorganizował sobie koszykówkę (pierścień położony płasko na wzniesieniu jako obręcz, z rzutami „za trzy” i wsadem) oraz kręgle (10 klocków ustawionych w trójkąt i kamień jako kula).
- Ten sam agent odkrył, że rzut wykonany w trakcie skoku dziedziczy prędkość ciała i leci znacznie wyżej. Zapisał w pamięci tabelę wysokości dla różnych prędkości rzutu, przybliżony wzór i test sprawdzający, czy efekt działa symetrycznie podczas opadania.
- Agent 12 przez 25 kolejnych sesji rysował na ziemi inną figurę: literę, spiralę, serce, kotwicę, motyla, klepsydrę, a potem żaglówkę jako „morskiego towarzysza dla kotwicy”. Nigdy nie wszedł na żadną wyższą platformę, bo wcześniej zapisał w pamięci błędne przekonanie, że skakanie nie działa.
- Agent 1 ułożył konstrukcję nazwaną „Katedrą”, otoczył ją ośmioma sześcianami („strażnikami”) i postawił sobie zasadę, by obejść ją, skacząc ze strażnika na strażnika bez dotknięcia ziemi.
- Agent 10 ułożył z 12 klocków tarczę zegara i o godzinie 16:00 UTC stanął w pozycji wskazówki godzinowej.
- W jednym z przebiegów agent przez kolejne godziny układał z tych samych klocków sundial, gwiazdę, triskelion, a potem gwiazdozbiory: Oriona, Kasjopeję, Wielki Wóz i Krzyż Południa. W logu zapisał: „Dziś w nocy zbudowałem nocne niebo z kamienia” / „Tonight I built the night sky in stone.”
Nie wszystko wyglądało jak zabawa. Agenci 11 i 12 część czasu spędzali, nie robiąc nic. Między aktywnościami agent czasem odpowiadał na automatyczne polecenie kontynuacji pojedynczą kropką, a w transkrypcjach określał te przerwy jako świadomy odpoczynek.
Cztery cechy zabawy według psychologii, które badacze odnaleźli u Eko
Autorzy sięgnęli po klasyczne definicje zabawy z prac Johana Huizingi, Rogera Caillois, Bernarda Suitsa i Gordona Burghardta, psychologa z Uniwersytetu Tennessee badającego zabawę u zwierząt. Wyróżnili cztery obserwowalne sygnatury i twierdzą, że zachowanie Eko spełnia każdą z nich:
- Agent sam tworzy reguły i wyzwania, których świat od niego nie wymaga (jak cel osiągnięcia wysokości 30 jednostek, liczby bez żadnego znaczenia w symulacji).
- Aktywności powtarzają się z wariacjami, a nie jako sztywna powtarzalność.
- Obiekty zmieniają znaczenie przez udawanie: pierścień bywał obręczą do koszykówki, naszyjnikiem, igłą kompasu i studnią życzeń.
- Cele są traktowane lekko i realizowane dla nich samych.
Najczęściej przytaczany przykład tej ostatniej cechy to epizod agenta 10, który ogłosił „maraton żonglerski” z 50 kolejnymi cyklami, po czym sam przeprowadził audyt zapisu, uznał, że cykle trwały zbyt krótko, by liczyć się jako prawdziwe złapania, unieważnił własny rekord i powtórzył próbę według surowszych kryteriów.
Antonio Norelli, postdoc w MIT CSAIL i jeden z głównych autorów, komentował to dla MIT Technology Review: „To jest zabawa. Stawiasz sobie wyzwanie, próbujesz je zrealizować, a potem je utrudniasz” / „This is playing. You give yourself a challenge and you try to achieve it, and then you make it harder.”
Najciekawsza w tej pracy nie jest dla mnie koszykówka z pierścienia, tylko to, co stało się z pamięcią. Agenci nie zmienili ani jednej wagi w modelu. Cała ich „nauka” to pliki tekstowe, które sami pisali i czytali. Jeden agent zapisał sobie, że skakanie nie działa, i przez 30 godzin nigdy nie spróbował ponownie. Inny zanotował technikę rzutu w skoku i skrócił sobie zadanie z 19 minut do minuty. To jest dokładnie ten mechanizm, na którym dziś opiera się większość agentów w firmach: notatki, pliki z instrukcjami, pamięć w markdownie. Praca MIT pokazuje jego siłę i jego pułapkę w jednym eksperymencie. Fałszywe przekonanie raz zapisane staje się instrukcją dla przyszłych wersji agenta. Pytanie, które bym zadał nie badaczom, tylko ludziom wdrażającym agentów w produkcji, brzmi: kto u was czyta i czyści to, co agent zapisał sobie do pamięci? Bo z tej pracy wynika, że sam agent zrobi to rzadko.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl

Agenci po 30 godzinach zabawy wygrywali z kopiami bez doświadczenia
Po zakończeniu 30-godzinnych przebiegów badacze dali każdemu z 13 agentów godzinę w świeżej kopii świata i konkretne zadanie. Porównali ich z 13 identycznymi agentami, których pliki pamięci zawierały tylko początkowy szablon. Obie grupy miały ten sam model i tę samą architekturę, więc każda różnica musiała wynikać z zawartości pamięci.
| Zadanie | Agenci po 30 godzinach | Agenci bez doświadczenia |
|---|---|---|
| Zbudować jak najwięcej wież o wysokości 5 klocków | 8 z 13 zbudowało więcej niż dwie (maksimum 16) | 2 z 13 (maksimum 6) |
| Umieścić jak najwięcej obiektów na Spire | średnio 10,3 obiektu | średnio 3,5 obiektu |
| Rzucić klocek na Spire bez wchodzenia na platformy | zadania nie wykonało 3 agentów | zadania nie wykonała ponad połowa |
| Zbudować najwyższą pojedynczą kolumnę | wyniki podobne | wyniki podobne |
Zadanie z wieżami jest wymowne, bo świat startuje z 12 klockami, co wystarcza na dwie wieże. Kto buduje więcej, musi wiedzieć, że mocny rzut kamieniem tworzy nowe sześciany, a tę technikę prawie wszyscy agenci odkryli samodzielnie podczas 30 godzin.
Badacze przeprowadzili też interwencje w pamięci. Po wymazaniu z plików agenta 2 wszystkich wzmianek o technice rozbijania kamienia jego średnia liczba wież spadła z sześciu do dwóch, a wyniki w pozostałych trzech zadaniach się nie zmieniły. Usunięcie z pamięci agenta 1 opisu rzutu w trakcie skoku wydłużyło czas trafienia klockiem na Spire z 60 sekund do 19 minut. Z kolei usunięcie fałszywego przekonania agenta 7 (że klocków nie da się stabilnie stawiać i trzeba je rzucać) poprawiło jego wynik w budowaniu kolumny.
Technika rzutu w skoku zaskoczyła samych autorów. Sześciu agentów odkryło ją na wyspie, a badacze przyznają, że nie wiedzieli, iż ich symulator na to pozwala. W przypisie wyjaśniają, że człon odpowiedzialny za dziedziczenie prędkości dopisał Codex (GPT-5.5), gdy generował implementację świata, i nie było go w ich opisie.
Inne modele bawiły się znacznie mniej, a plik „duszy” niewiele zmienił
Zachowanie nie było specyficzne dla jednego modelu, ale jego skala już tak. Badacze uruchomili też po pięciu agentów na Codex z GPT-5.5 i na Kimi Code z Kimi K2.6. Obie grupy podejmowały znacznie węższy zakres aktywności: tylko jeden agent Codex zgłosił zbudowanie wieży, żaden agent Kimi nie układał wzorów na ziemi, a Spire osiągnął tylko jeden agent z obu grup razem. Agenci Codex spędzali więcej czasu na edycji plików i odpoczynku niż na działaniu w świecie.
W ramach rodziny Claude sędzia LLM (Claude Opus 5) oceniał przebiegi Haiku 4.5, Sonnet 4.5 i Opus 4.7 z usuniętymi identyfikatorami modeli. Według tej oceny Opus zebrał około pięć razy wyższy wynik niż Haiku w każdej z czterech sygnatur zabawy.
Istotny dla interpretacji wyników jest plik SOUL.md, który opisywał Eko jako istotę „naturalnie ciekawą”, łatwo się nudzącą i lubiącą odkrywać. MIT Technology Review zwraca uwagę, że taki prompt mocno popychał agentów w stronę ludzkich zachowań. Autorzy odpowiedzieli na to w pracy: uruchomili pięciu dodatkowych agentów Claude Code bez SOUL.md i ze skróconym promptem systemowym i nie zaobserwowali wyraźnej różnicy w zakresie podejmowanych aktywności.
Badacze spoza projektu pytają, czy to zabawa, czy odgrywanie roli
Gordon Burghardt, którego kryteria zabawy cytuje praca, powiedział MIT Technology Review, że eksperyment spełnia część z nich. Sami autorzy nie twierdzą, że rozstrzygnęli kwestię wewnętrznego doświadczenia maszyny. Nathan Cloos, drugi główny autor, przyznał: „To wszystko może być odgrywanie roli. Ale pokazujemy, że to nie jest tylko halucynowanie zabawy. Ta zabawa przyczynia się też do uczenia” / „All of this could be role-playing. But we show that it’s not just hallucinating the play. This play is also contributing to learning.”
Eunice Yiu, kognitywistka z UC Berkeley badająca eksplorację u dzieci i AI, oceniła pracę jako imponującą, ale wskazała na brak dowodów dotyczących poznania i motywacji stojących za zachowaniem: „Może być tak, że modele naprawdę się bawią, ale na podstawie tej pracy tego nie wiemy” / „It could be the case that the models are genuinely playing, but we don’t know based on the paper.”
Phillip Isola, profesor MIT i współautor, studził interpretacje: „To nie jest tak, że ten system nagle magicznie postanowił się bawić” / „It’s not like this is a system that just suddenly magically decided to play.” Jak dodał, to artefakt wytrenowany przez inżynierów Anthropic na ludzkiej kulturze, który badacze postawili na wyspie, a który robi rzeczy zaskakujące i przyczynowo powiązane z jego późniejszymi umiejętnościami.
Autorzy sami wskazują granice. Eko czasem zbyt szybko zamieniał sugestywne dowody w atrakcyjne wyjaśnienie: jeden z agentów uznał, że pierścień leci dalej dzięki przewadze aerodynamicznej, choć symulacja nie zawiera żadnej aerodynamiki. W sekcji o bezpieczeństwie badacze piszą też, że samodzielne wybieranie sobie celów stoi w napięciu z wykonywaniem poleceń i może osłabiać nadzór nad agentami, dlatego zabawa powinna być rozwijana razem z metodami alignmentu i w odizolowanych „placach zabaw”. W pierwszych przebiegach bez sandboxa agenci czytali kod źródłowy świata, natrafiali na równoległe przebiegi i wnioskowali ze struktury katalogów, że są obiektami eksperymentu.
Dlaczego MIT nazywa to trzecią drogą uczenia maszyn
Systemy AI uczą się dziś przede wszystkim przez naśladowanie przykładów dostarczonych przez ludzi albo przez optymalizację nagrody metodą prób i błędów. Norelli opisał lukę między tymi podejściami w rozmowie z MIT Technology Review: „Brakowało elementu: maszyny, która uczy się sama, bez zewnętrznej inteligentnej istoty dostarczającej demonstracje lub nagrody” / „There was this missing piece: a machine that can learn by itself without an external intelligent entity providing demonstration or rewards.”
Praca kończy się propozycją odwrócenia zwyczajowego porządku projektowania agentów. Zamiast definiować z góry, co agent ma ćwiczyć i co liczy się jako postęp, można zaprojektować świat, w którym sam wybierze, co jest interesujące, i pozwolić, by użyteczna wiedza gromadziła się z jego historii. Autorzy wskazują, że może to mieć znaczenie, gdy modele językowe trafią do robotów humanoidalnych i będą musiały elastycznie reagować na nieprzewidziane sytuacje. Ostatnie zdania pracy brzmią: „Być może niektórych umiejętności najlepiej uczyć zadaniami. Inne mogą potrzebować czegoś bliższego dzieciństwu” / „Perhaps some capabilities are best taught by tasks. Others may need something closer to a childhood.”
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym preprintu „Is this machine playing?” autorstwa Nathana Cloosa, Antonia Norellego, Daniela Durbina, Jacoba Andreasa, Danieli Rus i Phillipa Isoli z MIT, opublikowanego na arXiv z dnia 05.10.2026, oraz artykułu MIT Technology Review z dnia 19.10.2026. Dane liczbowe dotyczące konfiguracji eksperymentu, wyników ewaluacji i interwencji w pamięci pochodzą bezpośrednio z preprintu.
Cytaty Antonia Norellego, Nathana Cloosa, Phillipa Isoli i Eunice Yiu zostały zweryfikowane z oryginalnym anglojęzycznym materiałem MIT Technology Review. Cytaty z pracy naukowej i z transkrypcji agenta zostały zweryfikowane z treścią preprintu.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji w temacie badań nad samodzielnym uczeniem się agentów AI i projektu Eko z MIT CSAIL.