
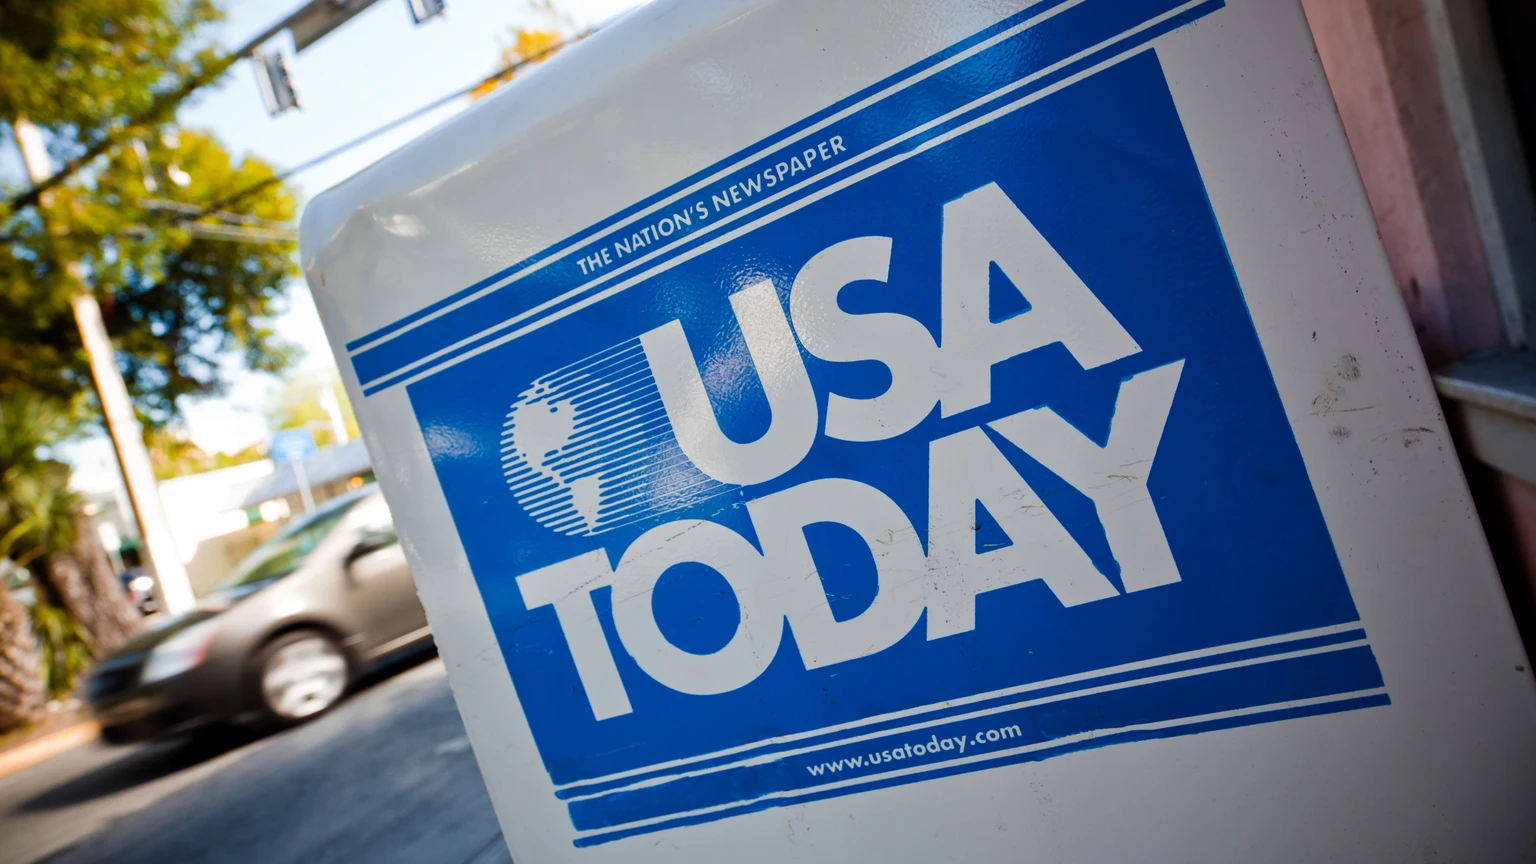
USA TODAY Co., do niedawna działający jako Gannett, wraz ze spółkami wydającymi 19 amerykańskich gazet pozwał OpenAI przed sądem federalnym w Nowym Jorku i żąda ponad 250 mln dolarów odszkodowania. Wydawca zarzuca OpenAI trenowanie modeli od GPT-1 do GPT-6.1 na setkach tysięcy artykułów bez zgody oraz udostępnianie w ChatGPT streszczeń, które zastępują czytelnikom oryginalne teksty.
- USA TODAY Co. (dawniej Gannett) wraz z 19 spółkami wydawniczymi pozwał OpenAI przed sądem federalnym w Nowym Jorku 8 października 2026 roku, żądając ponad 250 mln dolarów odszkodowania oraz zniszczenia wszystkich modeli GPT od GPT-1 do GPT-6.1.
- Według pozwu treści 19 gazet wydawcy stanowią ponad 160 tys. pozycji w zbiorze WebText, na którym trenowano GPT-2, a z analizy Washington Post wynika, że ich domeny odpowiadają za ponad 122 mln tokenów w zbiorze C4.
- Pozew twierdzi, że filtry blokujące odtwarzanie treści chronionych prawem autorskim nie obejmowały żadnego podmiotu, który nie pozwał OpenAI, a menedżer Microsoftu określił takie podejście wewnętrznie jako „przypadkowe tuszowanie".
Pozew wpłynął w czwartek 8 października 2026 roku do Sądu Okręgowego USA dla Południowego Dystryktu Nowego Jorku (sygnatura 1:26-cv-08892). Wydawcę reprezentuje Steven Lieberman z kancelarii Rothwell, Figg, Ernst & Manbeck, ten sam prawnik, który prowadzi sprawy dziennika New York Daily News i grupy MediaNews przeciwko OpenAI. Tym razem pozwanymi jest siedem podmiotów z grupy OpenAI, w tym OpenAI Foundation i OpenAI Group PBC. Microsoft nie jest stroną, choć pozew wielokrotnie opisuje jego rolę.
USA TODAY żąda ponad 250 mln dolarów i zniszczenia modeli GPT
Kwota 250 mln dolarów wynika z przepisów amerykańskiego prawa autorskiego. Za każde umyślne naruszenie można zasądzić do 150 tys. dolarów, a za każde usunięcie informacji o prawach autorskich (CMI, copyright management information, czyli danych o autorze, tytule, wydawcy i warunkach korzystania z tekstu) do 25 tys. dolarów. Przy setkach tysięcy artykułów górny pułap teoretycznie sięga znacznie wyżej.
Wydawca domaga się w pozwie:
- odszkodowania ustawowego i rzeczywistego oraz zwrotu korzyści uzyskanych przez OpenAI,
- uznania, że dotychczasowe i przyszłe korzystanie z treści gazet narusza prawa autorskie,
- stałego zakazu dalszych naruszeń,
- zniszczenia wszystkich modeli GPT i innych dużych modeli językowych oraz zbiorów treningowych zawierających treści wydawcy,
- procesu przed ławą przysięgłych.
Żądanie zniszczenia modeli pojawiało się już w pozwie The New York Times z grudnia 2023 roku. W praktyce jest to raczej narzędzie nacisku w negocjacjach niż realny scenariusz, ale formalnie obejmuje całą rodzinę modeli: GPT-1, GPT-2, GPT-3, GPT-4, GPT-4o, o1, o3, GPT-5 aż po GPT-6.1 i otwarty GPT-OSS, łącznie z wariantami Instant, Thinking, mini, nano i Pro.
Wnioskiem o uznanie sprawy za powiązaną USA TODAY chce dołączyć do skonsolidowanego postępowania In re OpenAI Copyright Infringement Litigation, które toczy się w tym samym sądzie.
Ponad 160 tys. tekstów z gazet USA TODAY w zbiorze treningowym GPT-2
Najtwardsze dane w pozwie pochodzą z materiałów, które OpenAI samo opublikowało. Lista domen zbioru WebText, na którym trenowano GPT-2, jest dostępna w repozytorium OpenAI na GitHubie. Według pozwu treści 19 gazet wydawcy stanowią w nim ponad 160 tys. pozycji. Wydawca powołuje się też na analizę Washington Post z 2023 roku, z której wynika, że jego domeny odpowiadają za ponad 122 mln tokenów w zbiorze C4, przefiltrowanej anglojęzycznej części archiwum Common Crawl z 2019 roku.
| Domena | Pozycje w WebText (GPT-2) | Tokeny w C4 |
|---|---|---|
| usatoday.com | 83 266 | 23 mln |
| freep.com (Detroit Free Press) | 12 994 | 8,2 mln |
| jsonline.com (Milwaukee Journal Sentinel) | 9 814 | 8,1 mln |
| azcentral.com (The Arizona Republic) | 9 073 | 12 mln |
| detroitnews.com (The Detroit News) | 7 028 | 8,1 mln |
| indystar.com (Indianapolis Star) | 6 726 | 7,6 mln |
Pozew przypomina także opublikowany przez OpenAI skład danych treningowych GPT-3. Common Crawl miał w nim wagę 60 proc., a WebText2, rozszerzona wersja WebText zbudowana z linków popularnych na Reddicie, 22 proc., choć stanowił mniej niż 4 proc. wszystkich tokenów. Wydawca argumentuje, że skoro OpenAI częściej próbkowało zbiory uznane za wartościowe, to teksty profesjonalnych redakcji miały dla trenowania modeli szczególną wartość.
Gazety twierdzą, że zablokowały roboty OpenAI w plikach robots.txt, a regulamin ich serwisów wprost zakazuje używania treści do trenowania i zasilania systemów AI. Pozew zarzuca też OpenAI używanie narzędzi Dragnet, Newspaper i Gutentag, które przy wycinaniu treści artykułów usuwały nazwiska autorów, informacje o prawach autorskich i stopki serwisów.
Pozew opiera się na wewnętrznych wiadomościach OpenAI z wcześniejszych procesów
Najmocniejsza część pozwu USA TODAY nie powstała w redakcjach gazet. Większość cytatów z wewnętrznej korespondencji OpenAI pochodzi z dokumentu złożonego we wrześniu 2025 roku w skonsolidowanym postępowaniu przeciwko OpenAI, czyli z materiałów ujawnionych w toku wcześniejszych procesów. Kolejni wydawcy dostają w ten sposób gotową amunicję.
Według pozwu Greg Brockman, współzałożyciel i prezes OpenAI, pisał do współpracowników, że modele są szczególnie dobre w przewidywaniu tekstu artykułów prasowych. Dario Amodei, wówczas szef badań w OpenAI, a dziś szef Anthropic, w prezentacji z 2020 roku wymienił generowanie newsów wśród umiejętności GPT-3. Wiceprezes ds. badań OpenAI miał stwierdzić, że celem trenowania sieci jest zapamiętywanie danych treningowych, a w czerwcu 2022 roku pracownicy firmy pisali o GPT-4, że model:
„zapamiętał mnóstwo danych i dlatego będzie szalenie dobry w odtwarzaniu ich” / „memorized a ton of data and therefore will be insanely good at regurgitation”
Pozew przytacza też reakcję Brockmana na wiadomość pracownika o sposobie obejścia paywalla New York Timesa przy pobieraniu treści. Według dokumentu Brockman odpowiedział krótko: „o, fajnie” / „ah nice”.
Osobny wątek dotyczy Microsoftu. Według pozwu Microsoft przez trzy lata przekazywał OpenAI kopię indeksu wyszukiwarki Bing w ramach projektu o nazwie kodowej Project Taxi, a dodatkowo prowadził na zlecenie i koszt OpenAI robota internetowego Project Mango, który miał zebrać jak najwięcej dokumentów do trenowania.
Najbardziej niewygodny dla OpenAI może się okazać zarzut dotyczący filtrów. Pozew twierdzi, że zabezpieczenia blokujące odtwarzanie treści chronionych prawem autorskim nie obejmowały żadnego podmiotu, który nie pozwał OpenAI. Menedżer Microsoftu, który zwrócił na to uwagę wewnętrznie, nazwał takie podejście:
„przypadkowym tuszowaniem” / „accidental cover up”
Uzasadnił to tym, że posiadacze praw do treści tracą wgląd w to, co zostało użyte do trenowania.

GPT-5.6 streszczał artykuły zamiast odsyłać do nich czytelników
USA TODAY dołączył do pozwu 19 przykładów, po jednym z każdej gazety. W każdym z nich model GPT-5.6, udostępniony w lipcu 2026 roku, dostał polecenie odnalezienia artykułu o podanym tytule i przygotowania szczegółowego streszczenia. Według pozwu odpowiedzi były wielosekcyjnymi omówieniami, które parafrazowały oryginał i odtwarzały jego strukturę: od nekrologu muzyka z Detroit, przez ranking śnieżyc w Rochester z zachowaną kolejnością i szczegółami, po tekst USA TODAY o reklamach politycznych generowanych przez AI.
Wydawca nie twierdzi tu, że model zapamiętał teksty. Chodzi o wyszukiwanie w czasie rzeczywistym, czyli RAG (retrieval augmented generation), technikę, w której model pobiera dokument z sieci i na jego podstawie buduje odpowiedź. Pozew zarzuca OpenAI, że celowo dotrenowało modele do streszczania artykułów zamiast zwracania samych tekstów, a takie streszczenia pełnią tę samą funkcję informacyjną co oryginał.
Na poparcie tej tezy wydawca cytuje szefa ChatGPT, według którego po otrzymaniu odpowiedzi nie ma dobrego powodu, by klikać w link do źródła. Nick Turley, szef ChatGPT, miał też napisać, że produkty OpenAI wobec wydawców są:
„w dużej mierze substytutem, kropka” / „largely substitutive, period”
Jeden z inżynierów OpenAI ujął to jeszcze dosadniej:
„bez względu na to, jak widocznie pokażemy linki, użytkownicy nie będą klikać” / „no matter how prominently we show the links, users won’t click”
Czytam ten pozew jako redaktor portalu, który sam codziennie opisuje cudze newsy, więc linia „streszczenie to też kradzież” nie jest dla mnie abstrakcją. Fakty nie podlegają ochronie prawa autorskiego i dobrze, że tak jest. Ale między omówieniem tematu na podstawie kilku źródeł a odtworzeniem jednego artykułu sekcja po sekcji jest różnica, którą każdy redaktor rozumie intuicyjnie. Pytanie, czy zrozumie ją sąd i ława przysięgłych.
Bardziej niepokoi mnie zarzut o filtrach. Jeśli się potwierdzi, to OpenAI chroniło treści tylko tych, którzy poszli do sądu. To fatalny sygnał dla całego rynku: wydawca, który chce być potraktowany poważnie, musi najpierw pozwać. Mniejsze redakcje, w tym europejskie, na taki proces zwykle nie mają pieniędzy.
Nie wierzę też, że skończy się na zniszczeniu modeli. Bardziej prawdopodobne są licencje i ugody, bo OpenAI już płaci części wydawców. Tyle że wtedy o tym, kto dostanie pieniądze za swoją pracę, zdecyduje wielkość kancelarii, a nie jakość dziennikarstwa.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl
USA TODAY dołącza do rosnącej grupy wydawców, którzy pozwali OpenAI
Pozew USA TODAY to kolejny z serii. The New York Times pozwał OpenAI i Microsoft w grudniu 2023 roku, a w kwietniu 2024 roku dołączyło osiem dzienników należących do Alden Global Capital, w tym New York Daily News i Chicago Tribune. W grudniu 2025 roku pozew złożył U.S. News & World Report, który według serwisu ChatGPT Is Eating the World był 16. sprawą o naruszenie praw autorskich przeciwko OpenAI. 24 czerwca 2026 roku wydawcy niemal 400 gazet pozwali OpenAI i Microsoft, a 4 września 2026 roku to samo zrobiły Seattle Times i Newsday.
Pozew podkreśla, że OpenAI wie, iż za treści trzeba płacić, bo podpisało umowy licencyjne z kilkunastoma organizacjami medialnymi, m.in. Associated Press, Axel Springer, The Atlantic i Vox Media. USA TODAY takiej umowy nie ma.
Skala biznesu, na którą powołuje się wydawca, pochodzi z komunikatów samego OpenAI:
- w marcu 2026 roku ChatGPT miał ponad 900 mln aktywnych użytkowników tygodniowo i ponad 50 mln płacących subskrybentów,
- w lutym 2026 roku OpenAI podało, że pytania o lokalne newsy trafiają do ChatGPT w tempie około 1 mln tygodniowo,
- w sierpniu 2026 roku biznes reklamowy ChatGPT osiągnął roczne tempo przychodów 1 mld dolarów,
- według pozwu ostatnia rekapitalizacja wyceniła OpenAI na około 852 mld dolarów, a firma złożyła w SEC dokumenty związane z wejściem na giełdę.
Pozew zawiera też wyliczenie, które dobrze pokazuje ekonomię problemu: według cennika API OpenAI wygenerowanie miliona artykułów w stylu prasowym, po około 500 słów każdy, kosztuje mniej więcej 6800 dolarów.
OpenAI w poprzednich sprawach broniło się doktryną fair use, czyli amerykańską instytucją dozwolonego użytku, oraz argumentem, że trenowanie modeli ma charakter transformacyjny. W materiałach dostępnych w dniu publikacji nie znalazłem oficjalnej odpowiedzi OpenAI na pozew USA TODAY.
Polscy wydawcy mogą zastrzec swoje treści przed trenowaniem AI
W Polsce i całej Unii Europejskiej spór o trenowanie modeli na artykułach toczy się na innych zasadach niż w USA. Polskie prawo nie zna amerykańskiego fair use. Nowelizacja ustawy o prawie autorskim i prawach pokrewnych z 2024 roku, wdrażająca unijną dyrektywę o prawie autorskim na jednolitym rynku cyfrowym (DSM), wprowadziła dozwolony użytek w postaci eksploracji tekstów i danych (TDM, text and data mining). Zasada jest prosta: wolno kopiować rozpowszechnione utwory do eksploracji, chyba że uprawniony zastrzegł inaczej w odpowiedni sposób.
Ta sama nowelizacja dała wydawcom prasy nowe prawo pokrewne do korzystania online z ich publikacji przez platformy internetowe. Dodatkowo AI Act zobowiązuje dostawców modeli ogólnego przeznaczenia do prowadzenia polityki przestrzegania prawa autorskiego, w tym respektowania takich zastrzeżeń.
W praktyce oznacza to, że polski wydawca, który chce chronić swoje treści, musi aktywnie zgłosić sprzeciw, np. w robots.txt, regulaminie serwisu lub w samej publikacji. Część branży już to robi: wydawnictwo Wielka Litera umieszcza w książkach klauzulę zakazującą użycia treści do trenowania AI i zapowiada podobne zapisy w e-bookach i audiobookach. Sprawa USA TODAY pokazuje jednak, że samo zastrzeżenie nie wystarcza, jeśli nie da się sprawdzić, co trafiło do zbiorów treningowych. Amerykańscy wydawcy wiedzą to głównie dzięki dokumentom ujawnionym w procesach. Polscy na razie takiego materiału nie mają.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym pozwu USA Today Co., Inc. przeciwko OpenAI Foundation złożonego w Sądzie Okręgowym USA dla Południowego Dystryktu Nowego Jorku z dnia 08.10.2026, rejestru sprawy w CourtListener oraz Unite.AI. Kontekst wcześniejszych pozwów wydawców zweryfikowano m.in. w materiałach Reuters, Shacknews i ChatGPT Is Eating the World, a polski kontekst prawny w Infor.pl.
Cytaty pracowników OpenAI i Microsoftu, w tym Nicka Turleya, szefa ChatGPT, oraz Grega Brockmana, prezesa OpenAI, zostały zweryfikowane z oryginalnym anglojęzycznym tekstem pozwu. Są to zarzuty i cytaty przytoczone przez powoda, które nie zostały jeszcze rozstrzygnięte przez sąd.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji w sprawie pozwu USA TODAY przeciwko OpenAI.