
Meta udostępniła 12 października 2026 r. rodzinę modeli Muse Wonder (wewnętrzna nazwa kodowa: Watermelon), swoje pierwsze modele klasy frontier. Najmocniejszy wariant, Muse Wonder Full, zdobył 56 pkt w niezależnym Artificial Analysis Intelligence Index i ustępuje tylko Claude Opus 5.5 (58 pkt), a we własnych testach Mety wygrywa z konkurencją w pracy prawniczej, długich projektach programistycznych i zapamiętywaniu kontekstu.
- Meta udostępniła 12 października 2026 r. rodzinę modeli Muse Wonder, które w niezależnym Artificial Analysis Intelligence Index v4.3 zdobyły 56 pkt (Muse Wonder Full) i 52 pkt (Muse Wonder), co oznacza skok o 8 pkt względem poprzedniego modelu Muse Spark 1.3 (48 pkt) w ciągu zaledwie sześciu tygodni.
- Muse Wonder Full jest dostępny wyłącznie dla płacących subskrybentów Muse Code w planach Power (50 dolarów miesięcznie) lub Maximum (200 dolarów miesięcznie) i nie jest udostępniany przez API, podczas gdy Muse Wonder w API kosztuje 4 dolary za milion tokenów wejściowych i 20 dolarów za milion tokenów wyjściowych.
- Mimo że Muse Wonder Full osiąga najlepszy wynik w teście prawniczym Harvey LAB-AA (13,1 pkt wobec 4,2 pkt Claude Opus 5.5), oznacza to poprawne ukończenie jedynie około 13 proc. zadań, a w teście wiedzy ogólnej AA-Omniscience Muse Wonder Full uzyskuje tylko 30 pkt wobec 46 pkt Claude Opus 5.5.
Premierę ogłosił Mark Zuckerberg we wpisie na X. Napisał, że Muse Wonder to:
„znacznie większa i bardziej zaawansowana klasa modeli, która wprowadza nas do czołówki” / „much larger and more advanced class of models that brings us to the frontier”
Introducing Muse Wonder, our new family of frontier models with state of the art performance for personal and professional agentic work. pic.twitter.com/NKHrybrGKQ
— Mark Zuckerberg (@finkd) October 12, 2026
Dwa modele: Muse Wonder w API, Muse Wonder Full tylko w Muse Code
Muse Wonder trafił od razu do Meta Model API i Muse Code, terminalowego agenta programistycznego Mety. Muse Wonder Full jest dostępny wyłącznie dla płacących subskrybentów Muse Code i Meta nie udostępnia go przez API. Według Mety oba modele mają wkrótce napędzać też agenta Muse, najpierw u płacących użytkowników.
Najważniejsze parametry:
- Cena Muse Wonder w API: 4 dolary za milion tokenów wejściowych, 0,20 dolara za tokeny z cache i 20 dolarów za milion tokenów wyjściowych. To tyle samo co Claude Opus 5.5.
- Okno kontekstowe: 1 mln tokenów.
- Wejście: tekst, obraz, wideo i dźwięk. Wyjście: tekst.
- Muse Wonder Full: nie ma ceny za token. Dostęp dają plany Muse Code Power (50 dolarów miesięcznie) i nowy Maximum (200 dolarów miesięcznie).
- Wagi modelu: zamknięte. W przeciwieństwie do Muse Glimmer, 30-miliardowego modelu, który można pobrać, Meta nie zapowiada otwarcia Wonder.
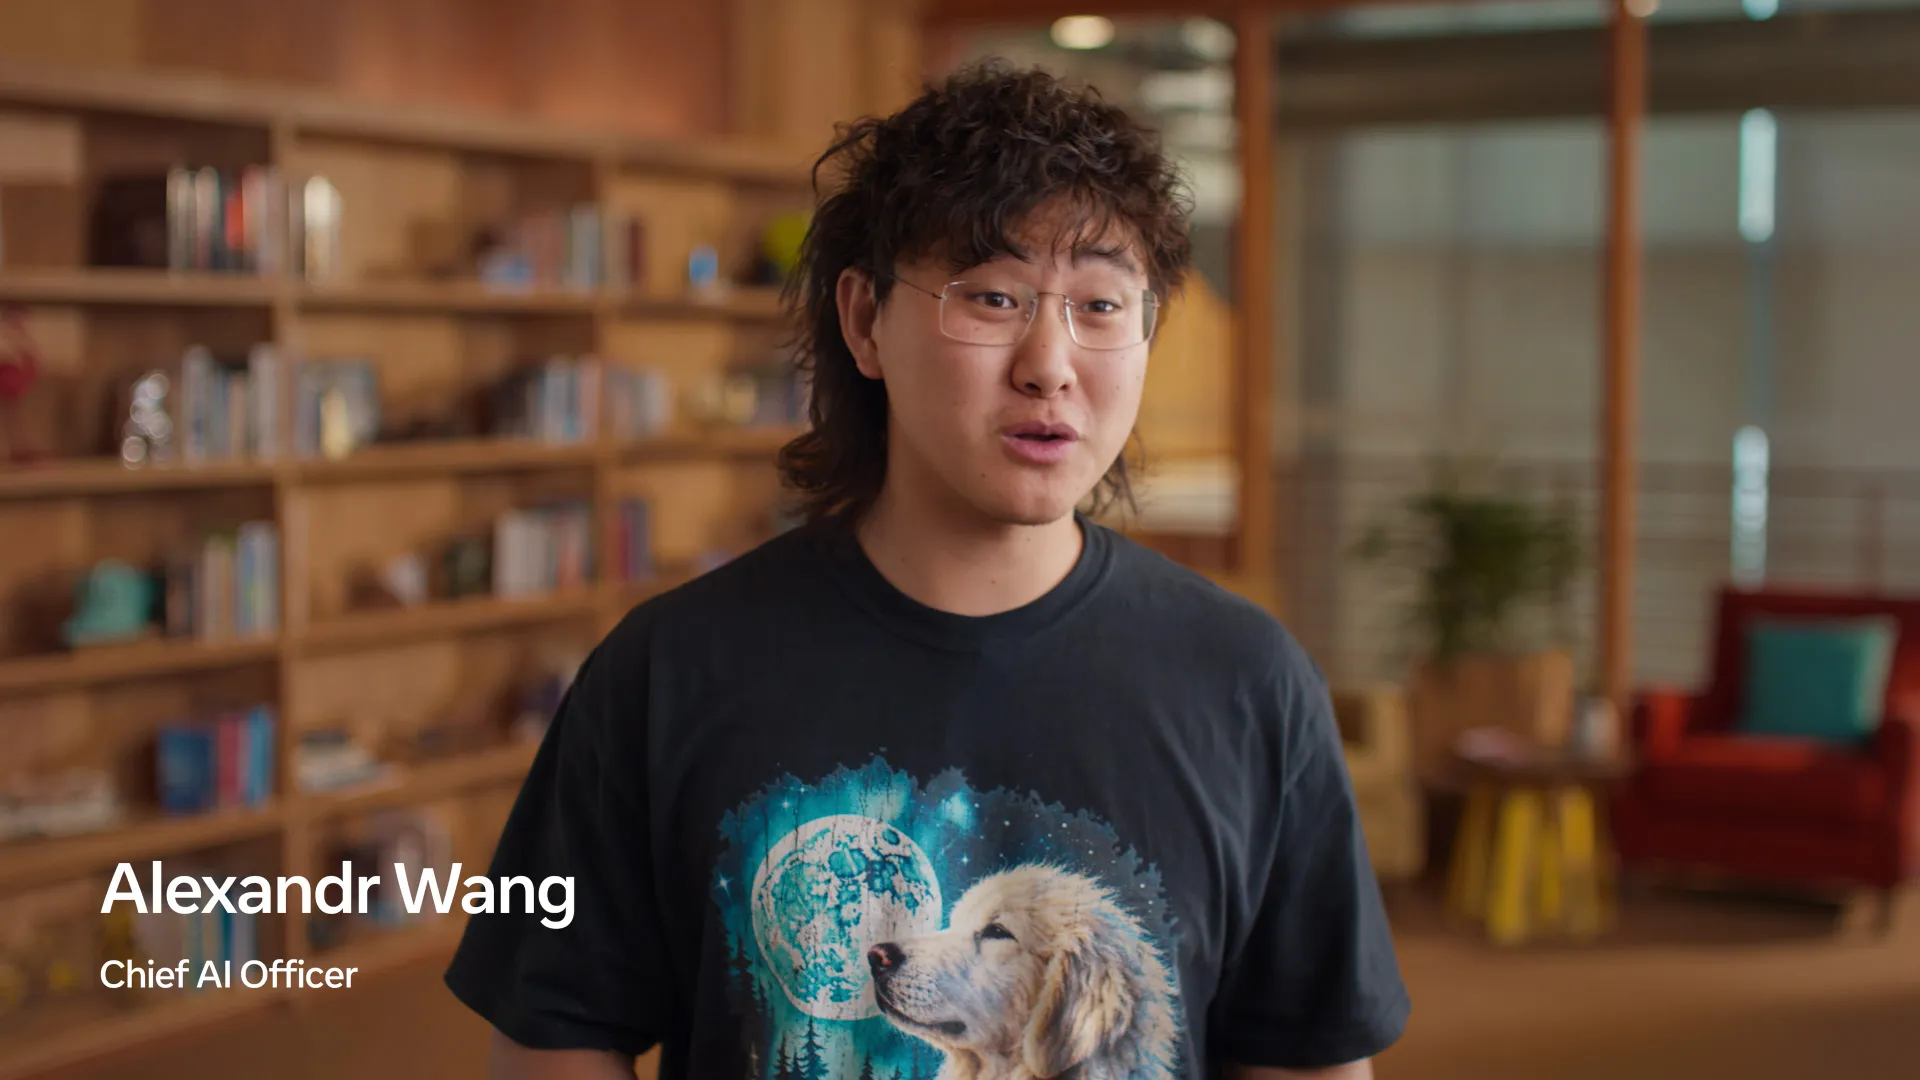
Meta podaje, że modele trenowano w jej gigawatowym centrum danych Prometheus. To pierwsza premiera tej klasy od czasu, gdy Alexandr Wang, założyciel Scale AI i obecny szef AI w Mecie, przebudował dział sztucznej inteligencji. Meta sama określa ten proces jako trwającą 14 miesięcy przebudowę „od podstaw”.
Muse Wonder Full prowadzi w testach prawniczych, pamięci i długim kodowaniu
Najlepsze wyniki Muse Wonder Full osiąga w zadaniach agentowych rozłożonych w czasie. W tabeli Mety z 14 testami model wygrywa m.in. w Harvey LAB-AA, MemoryBench, DeepSWE 1.1 i SWE-Marathon:
| Test | Muse Wonder Full | Muse Wonder | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| Harvey LAB-AA (praca prawnicza) | 13,1 | 10,0 | 4,2 | 8,6 |
| DeepSWE 1.1 (inżynieria oprogramowania) | 79,0 | 78,8 | 74,2 | 74,1 |
| SWE-Marathon (wielogodzinne projekty) | 57,5 | 53,1 | 46,3 | b.d. |
| MemoryBench (pamięć kontekstu) | 85,5 | 85,6 | 81,5 | 81,4 |
Za tymi liczbami stoją różne źródła. Wynik Harvey LAB-AA pochodzi od Artificial Analysis, DeepSWE od firmy Datacurve, a SWE-Marathon od Abundant AI. Model card Mety zaznacza, że Muse Wonder Full w SWE-Marathon testowano na poziomie rozumowania xhigh. Konkurencyjne modele GPT i Claude pracowały tam w swoich własnych narzędziach (Codex i Claude Code), więc nie było to porównanie w identycznym środowisku.
MemoryBench to wewnętrzny test Mety. Sprawdza, jak model przypomina sobie fakty z rozmów liczących od 64 do 100 tys. tokenów, w których pojawiają się rozpraszacze i późniejsze korekty danych.
Wynik 13,1 w Harvey LAB-AA wymaga komentarza. Test zalicza zadanie tylko wtedy, gdy dokument prawny spełnia wszystkie kryteria i przechodzi kontrolę halucynacji. Muse Wonder Full jest tu najlepszy, ale poprawnie domyka nieco ponad 13 proc. zadań.

Claude Opus 5.5 nadal prowadzi w niezależnym indeksie i w części testów
Artificial Analysis, niezależna firma testująca modele AI, przyznała Muse Wonder Full 56 pkt, a Muse Wonder 52 pkt w Intelligence Index v4.3. Poprzedni model Mety, Muse Spark 1.3, miał 48 pkt, a od jego premiery minęło tylko sześć tygodni. Claude Opus 5.5 ma 58 pkt, Claude Sonnet 5.5 również około 56 pkt.
Artificial Analysis wskazuje mocne i słabe strony nowego modelu Mety:
- Muse Wonder Full jest pierwszy w testach CritPt (rozumowanie naukowe) i GDP.pdf (praca na dokumentach PDF), ale przewaga nad kolejnymi modelami wynosi 1-2 pkt.
- W Coding Agents Index Muse Wonder Full w Muse Code zdobył 68 pkt, tyle samo co Claude Code z Sonnet 5.5 i więcej niż Claude Code z Opus 5.5 (66 pkt).
- Słabszą stroną pozostaje wiedza: w AA-Omniscience Muse Wonder Full ma 30 pkt, Claude Opus 5.5 46 pkt.
- Muse Wonder Full halucynuje rzadko. Wskaźnik spadł z 33 do 23 proc. i jest drugim najniższym wśród modeli powyżej 45 pkt w indeksie.
W samej tabeli Mety Claude Opus 5.5 wygrywa w zadaniach najbardziej przypominających pracę programisty przy terminalu. W Terminal-Bench 4.0 Opus 5.5 ma 59,6 pkt wobec 52,0 dla Muse Wonder, a w ProgramBench 70,5 wobec 50,0.
Muse Wonder jest tańszy od Claude Opus 5.5 w przeliczeniu na zadanie
Choć ceny za token są identyczne, Artificial Analysis policzyła, że pełny przebieg jednego zadania z indeksu kosztuje z Muse Wonder 4,52 dolara. Claude Opus 5.5 wychodzi na 5,98 dolara, Claude Fable 5.1 na 7,63 dolara, a GPT-6 Astra na 3,26 dolara. Muse Wonder zużywa przy tym 2,8 raza więcej pieniędzy niż Muse Spark 1.3 (1,60 dolara), głównie przez wyższe stawki i duże zużycie tokenów wejściowych (7,69 mln na zadanie).
W cenniku per token Muse Wonder jest dwa razy droższy od Claude Sonnet 5.5, Gemini 4 Argon i GPT-6.1 Sol (2/10 dolarów) i o 60 proc. tańszy od GPT-6 Astra i Claude Fable 5.1 (10/50 dolarów).
Meta wreszcie ma model, z którym trzeba się liczyć. Skok z 48 do 56 pkt w niezależnym indeksie w sześć tygodni robi wrażenie i nie da się go zbyć jako marketingu.
Ale widzę tu też starannie dobraną narrację. Najbardziej efektowne wyniki pochodzą z wewnętrznych testów (MemoryBench) albo z porównań, w których konkurenci pracowali w innych narzędziach. A 13 proc. w teście prawniczym to „najlepszy wynik”, który oznacza, że w 87 przypadkach na 100 dokument nie przechodzi kontroli. Prawnicy jeszcze długo nie muszą się martwić.
Bardziej zastanawia mnie model biznesowy. Najmocniejszy wariant jest zamknięty w subskrypcji Muse Code i niedostępny przez API. Firma, która chciałaby zbudować na Muse Wonder Full własny produkt, po prostu nie może tego zrobić. Czy to tymczasowa ostrożność, czy sposób na przywiązanie programistów do własnego ekosystemu? Na razie Meta nie odpowiada. Nie ma też jeszcze pełnego raportu bezpieczeństwa, który firma obiecuje „wkrótce”.
Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl
Meta obiecuje najsilniejsze zabezpieczenia, raport bezpieczeństwa dopiero powstaje
Meta nazywa Muse Wonder swoim „najlepiej dostrojonym” modelem i deklaruje najsilniejsze dotąd zabezpieczenia przed nadużyciami w obszarze broni CBRN (chemicznej, biologicznej, radiologicznej i jądrowej) oraz cyberataków. W model card firma przyznaje, że bez zabezpieczeń nie wyklucza osiągnięcia przez model wysokiego progu ryzyka w obszarze chemiczno-biologicznym, dlatego zastosowała dodatkowy trening i klasyfikatory na poziomie systemu. Po ich wdrożeniu Meta ocenia ryzyko jako „umiarkowane lub niższe” we wszystkich badanych obszarach.
Model card zawiera też listę ograniczeń. Meta przyznaje, że rozumowanie wizualne i przestrzenne, zwłaszcza w 3D, pozostaje słabym punktem, a model nie był testowany we wszystkich językach z danych treningowych.
Jak wygląda dostępność Muse Wonder w Polsce?
Agent Muse, w którym Muse Wonder ma się pojawić najpierw, ruszył we wrześniu w USA (iOS, Android i wersja webowa) i według polskich mediów nie jest jeszcze dostępny w Polsce. Meta w ogłoszeniu Muse Wonder nie podała listy krajów ani terminu udostępnienia modelu darmowym użytkownikom.
Inaczej może być z narzędziami dla programistów. Meta Model API działa w publicznej wersji testowej z „rozszerzonym globalnym dostępem”, a w sierpniowej sprawie blokady Muse Code dla Ukrainy zgłaszający problem wskazywał, że z adresów IP innych krajów europejskich narzędzie działało. Przed wykupieniem planu warto jednak samodzielnie sprawdzić dostęp, bo Meta oficjalnie tego nie potwierdziła.
Dla Polski i całej UE ważny jest też kontekst regulacyjny. Meta odmówiła podpisania unijnego kodeksu praktyk dla modeli AI ogólnego przeznaczenia, a modele uznane za niosące ryzyko systemowe podlegają obowiązkom z AI Act niezależnie od licencji. To może wpłynąć na tempo, w jakim Muse Wonder trafi do europejskich użytkowników aplikacji Muse.
Źródła i metodologia
Artykuł powstał na podstawie analizy redakcji AIPORT.pl oraz dodatkowych źródeł, w tym oficjalnego komunikatu Meta Newsroom i wpisu na blogu Meta AI Research z dnia 12.10.2026, model card Muse Wonder oraz niezależnej analizy Artificial Analysis. Wyniki z tabeli benchmarków Mety zweryfikowano w publikacjach MarkTechPost, Technology.org, Memeburn i The Next Web, a informacje o dostępności w Polsce w serwisach XYZ.pl i DOU.
Cytat Marka Zuckerberga, prezesa Mety, został zweryfikowany z oryginalnym anglojęzycznym wpisem na X.
Komentarz redakcyjny i ocena kontekstu branżowego: Piotr Wolniewicz, Redaktor Naczelny AIPORT.pl.
Artykuł będzie aktualizowany w miarę pojawiania się nowych informacji o modelach Muse Wonder, ich dostępności w Polsce i pełnym raporcie bezpieczeństwa Mety.